

IA : ce n'est pas le "merci" qui coûte, c'est la conversation qui s'allonge

Dire " merci " à une IA coûte peu. Ce qui coûte, c'est le fil qui s'allonge et se renvoie en entier à chaque message. Solution : une conversation mère qui pilote, des filles à une tâche chacune.
Un post publié récemment sur LinkedIn posait la question : combien coûtent nos "merci" à ChatGPT et à Claude ? L'auteur faisait le calcul avec humour, à partir d'hypothèses assumées : 120 millions d'utilisateurs, 8 remerciements par jour, soit environ 350 milliards de "merci" par an.
J'ai passé ces volumes dans un calculateur en ligne. Pour un "merci" isolé, avec un modèle de la taille de Claude Sonnet 5.5, on obtient environ 23 GWh par an. Avec un petit modèle, moins de 1 GWh. Le choix du modèle pèse trente fois plus que la politesse.
Mais le chiffre le plus intéressant était ailleurs. Un "merci" n'est jamais envoyé seul.
Tout le fil repart à chaque message
Un modèle de langage n'a pas de mémoire entre deux messages. Pour qu'il "se souvienne" de la conversation, l'application lui renvoie en général, à chaque tour, tout ou une grande partie de ce qui a été échangé depuis le début : vos messages, ses réponses, les consignes du projet, les documents joints. Un "merci" envoyé à la fin d'un long échange, c'est le "merci" plus des milliers de tokens d'historique.
Sur le même scénario, un "merci" envoyé en fin de conversation, avec 5 000 tokens renvoyés, multiplie l'énergie estimée par dix et fait passer la valeur au tarif API d'environ 100 millions à 3,6 milliards de dollars par an.
Le coût d'une conversation ne croît donc pas avec sa longueur, il croît plus vite qu'elle. Quand l'historique est renvoyé en entier, chaque nouvel échange rejoue tous les précédents : au centième message, on paie de nouveau les quatre-vingt-dix-neuf autres. Prenons un projet de 60 échanges, avec des messages de 200 tokens, des réponses de 300 et 1 500 tokens de consignes et de fichiers de projet : il fait traiter au modèle près d'un million de tokens au total.
Les fournisseurs ont une parade, le cache. Un historique déjà traité est relu à moindre coût : chez Anthropic, une lecture en cache est facturée de 10 à 40 fois moins cher qu'un token d'entrée selon le modèle (20 fois pour Sonnet 5.5 et Opus 5.5, 40 fois pour Fable 5.1, 10 fois pour Haiku 5.5), et l'estimation d'énergie du dépôt open source claude-carbon la compte pour environ 8 % d'un token d'entrée. Les applications grand public ont toutes les raisons de s'en servir, même si leur fonctionnement interne n'est pas public. Le cache allège la facture. Il ne règle pas le second problème.
Plus long, c'est aussi moins bien
Une conversation qui s'allonge ne coûte pas seulement plus cher, elle répond moins bien. Dès 2023, des chercheurs emmenés par Nelson Liu, à Stanford, ont montré que les modèles exploitent mal l'information placée au milieu d'un long contexte. Le phénomène a résisté aux générations suivantes. En juillet 2025, la société Chroma a testé 18 modèles, dont o3, Claude 4 et Gemini 2.5, avec et sans mode de raisonnement, sur des tâches volontairement simples et contrôlées : leur fiabilité diminue à mesure que l'entrée s'allonge. Ces tâches ne sont pas des conversations ordinaires, mais l'effet va dans le sens de ce que chacun observe.
Monter le niveau de raisonnement ne suffit pas. Chez Chroma, le mode réflexion améliore nettement les scores, mais l'écart entre la version courte et la version longue d'une même tâche persiste. Le banc d'essai NoLiMa, présenté par Adobe Research et l'université LMU de Munich à la conférence ICML 2025, est plus net encore : sur un sous-ensemble de 10 questions parmi les plus difficiles, le modèle de raisonnement o1 d'OpenAI répond juste dans 92 % des cas avec 4 000 tokens de contexte, 78 % à 8 000 et 31 % à 32 000. Une prépublication de 2026, "Reasoning Shift", montre enfin qu'un historique de conversation fait raisonner les modèles moins longtemps et vérifier moins leur propre travail, y compris un modèle réglé en effort très élevé. Aucune de ces études ne teste les modèles les plus récents d'Anthropic ou d'OpenAI en effort maximal, mais rien n'indique que ce réglage compense un contexte surchargé.
Chacun en a fait l'expérience : passé un certain stade, le modèle oublie une consigne donnée au début, mélange deux versions d'un document, se répète. On reformule, on régénère, on corrige. Chaque reprise produit du texte, et c'est précisément le texte produit qui coûte le plus. Avec les facteurs de claude-carbon, un token écrit par Claude Sonnet 5.5 consomme environ 21 fois plus d'énergie qu'un token lu.
Changer de modèle en cours de route ne règle rien
Le réflexe le plus répandu aggrave le problème : on ouvre une conversation sur le modèle le plus puissant et on lui confie tout, de la stratégie à la mise en forme d'un tableau. Les tâches simples n'en ont pas besoin, mais en changer coûte cher.
Car changer de modèle au milieu d'une conversation ne transmet pas ce que le premier a "compris". Le nouveau modèle relit toute la conversation depuis le début, et le cache ne l'aide pas : il conserve des calculs faits par l'ancien modèle, inutilisables par un autre. Plus la conversation est longue, plus le changement est cher. Et le nouveau modèle hérite du même historique surchargé, donc de la même perte de précision. En pratique, on reste sur le gros modèle.
La solution n'est pas de mieux gérer une conversation longue. C'est de s'organiser avant de commencer.
La méthode de la conversation mère
Voici la méthode, en cinq règles. Elle ne dépend d'aucun fournisseur : elle s'applique avec tous les outils qui permettent de regrouper ses conversations par projet ou par dossier, chez OpenAI, chez Anthropic et ailleurs.
- Une conversation mère qui pilote et ne produit pas. Pour chaque projet, une conversation sert de poste de commande : elle fixe l'objectif, découpe le travail en tâches et garde la vue d'ensemble. Elle peut tourner sur un modèle élevé, parce qu'elle raisonne sur la structure du projet. Mais elle écrit peu : des décisions et des briefs, jamais les livrables.
- Une conversation fille par tâche, ouverte par un brief. C'est la mère qui rédige le message de départ de chaque fille. Ce brief contient quatre éléments : un objectif, un format de sortie attendu, les sources à utiliser et les limites de la tâche. Ce ne sont pas mes catégories : ce sont celles qu'Anthropic recommande pour déléguer à ses propres sous-agents. Une fille vit le temps de sa tâche, quelques échanges, puis on la ferme.
- Des documents dans un dossier, pas dans le fil. Les fichiers de référence restent dans un dossier relié au projet et ne sont appelés que lorsqu'une fille en a besoin. Coller trois fois le même PDF dans une conversation, c'est le faire relire à chaque message.
- Une synthèse humaine qui remonte, pas la conversation. Quand une fille a fini, elle produit un compte rendu de quelques lignes, et c'est lui seul qui remonte à la mère. Anthropic a mesuré, sur son système de recherche, que les systèmes multi-agents consomment environ 15 fois plus de tokens qu'un simple chat. Ce chiffre ne mesure pas ma méthode, pilotée par un humain, mais il rappelle qu'orchestrer n'est sobre que si l'on borne ce qui circule. Cette synthèse, c'est l'utilisateur qui la relit, la corrige ou la réécrit avant de la transmettre. C'est le moment où il reprend la main, et où il évite de laisser un modèle devenir l'environnement de sa pensée.
- Le modèle choisi à l'ouverture, fille par fille. C'est la règle qui fait toute la différence. Chaque fille démarre directement sur le modèle qui convient à sa tâche : un petit modèle pour mettre en forme, traduire ou résumer, un modèle plus puissant pour une analyse délicate, un modèle adapté à la critique quand il faut éprouver un raisonnement. Le choix se fait une fois, sur un contexte court, sans rien relire.
Trois effets en découlent, et ils se renforcent. On choisit le bon modèle sans jamais payer de changement en cours de route. Les conversations sont courtes par construction, et non par discipline : l'historique reste léger. Et chaque modèle travaille dans la zone où il est fiable, ce qui épargne une partie des reprises.
Bonus : deux réglages qui rendent la méthode durable
La méthode tient si chaque fille repart d'un cadre stable plutôt que de zéro.
Des instructions globales précises. Un seul texte, appliqué à toutes les conversations. Il dit qui je suis et sur quoi je travaille, comment je veux qu'on me réponde (direct, concis, niveau technique assumé), et qu'il faut distinguer ce qui est établi de ce qui est supposé et relire un chiffre à la source plutôt que le recopier de mémoire. Il fixe trois niveaux d'autonomie : ce que l'IA fait seule, ce qui demande un plan puis mon accord, ce qui demande une double confirmation (supprimer, publier, envoyer). Il impose aussi un modèle par défaut moins coûteux, avec les cas où en changer. Chaque fille arrive ainsi avec le cadre déjà posé, sans le réexpliquer à chaque ouverture.
Un dossier de sortie par projet. Chaque projet a un numéro et un dossier du même numéro, rangé par trimestre, avec un nom qui se trie : 2026-10-19_04-presse_chronique_v5.md. Chaque livrable se range seul, la mère retrouve en une ligne ce que chaque fille a produit, et rien ne se perd dans le fil.
Ce que la méthode gagne
J'ai modélisé ce scénario avec les facteurs publics d'énergie (claude-carbon pour Anthropic, EcoLogits pour OpenAI), en tenant compte du cache. Le projet de 60 échanges devient six filles de dix échanges, pilotées par une mère, dont trois confiées au petit modèle de la même famille. Comparée à la même conversation menée d'un bout à l'autre sur le modèle principal :
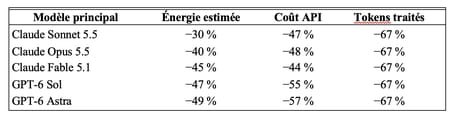 Hypothèses : messages de 200 tokens, réponses de 300, 1 500 tokens de consignes et de fichiers, briefs de 400 tokens ; mère de 13 échanges aux réponses de 200 tokens ; petit modèle Claude Haiku 5.5 ou GPT-6 Luna ; écritures et lectures de cache comptées pour chaque modèle ; historique renvoyé en entier à chaque message ; 20 % de reprises dans la conversation unique ; en cas de changement de modèle, cache supposé expiré au retour (durée par défaut de 5 minutes chez Anthropic). Pour GPT, l'énergie des tokens lus est extrapolée des facteurs de claude-carbon.
Le contexte le dit autrement : en fin de conversation unique, le modèle traite 31 000 tokens à chaque message ; dans une fille, jamais plus de 6 400. Dans NoLiMa, c'est l'écart entre 78 à 92 % de bonnes réponses pour o1 sur son sous-ensemble de questions difficiles, et 31 %.
Deux vérifications confirment que le gain tient à l'organisation. Garder une seule conversation en changeant de modèle à chaque tâche fait moins bien : dans les scénarios modélisés, la méthode reste de 7 à 16 % plus sobre en énergie et de 22 à 28 % moins chère. Et la mère doit rester sobre : si elle rédige des réponses deux fois plus longues, le gain d'énergie tombe à 20 à 39 %.
Ces chiffres sont théoriques, et je les présente comme tels. Le taux de reprises évitées est une hypothèse que personne ne peut aujourd'hui vérifier de l'extérieur. Et la méthode EcoLogits, qui sert à estimer les modèles d'OpenAI, de Google ou de Mistral, ne compte que les tokens produits : selon elle, l'historique renvoyé ne consomme rien. Ce n'est évidemment pas le cas, et j'ai dû extrapoler. Le même geste coûte dix fois plus d'énergie, ou rien de plus, selon la méthode retenue. Ce n'est pas un détail technique : c'est la preuve que nous mesurons l'IA avec des instruments incomplets.
Personne ne l'enseigne
J'ai cherché des formations qui apprennent à utiliser l'IA générative sobrement. Les catalogues des chambres de commerce, des organismes privés et des grandes plateformes enseignent le prompt, la productivité et la performance. Dans le meilleur des cas, l'impact environnemental y occupe une ligne de programme. Les ressources de sensibilisation existent, comme celles de l'Open University ou de Queen Mary University à Londres, mais elles conseillent surtout de préférer le texte à l'image et les petits modèles. Elles ne disent rien de l'organisation des conversations. Et l'"IA frugale" s'adresse à ceux qui conçoivent les modèles, pas à ceux qui les utilisent.
Je n'ai trouvé aucune formation qui fasse de la sobriété d'usage un objectif. L'ADEME juge pourtant, dans son avis de juillet 2026, la formation "cruciale" pour un usage raisonné de l'IA. Le chaînon manquant est là : on apprend à obtenir plus de l'IA, jamais à lui demander moins.
Rendre la sobriété mesurable
L'usage de l'IA grandit plus vite que notre capacité à le penser. Il est encore temps d'installer de bonnes habitudes, à condition de les rendre visibles. Nous avons appris, à l'échelle mondiale, une hygiène de l'eau. Il faut apprendre celle de la donnée : on peut utiliser l'IA, on n'a plus le droit de la gaspiller dans des requêtes mal formulées ou des architectures paresseuses.
On pourrait imaginer un label vert pour les applications d'IA, sur le modèle de l'étiquette énergie européenne, fondé sur cinq critères : l'efficacité en tokens, la discipline de cache, le routage vers le modèle qui suffit, la gestion du contexte et la transparence. La méthode de la conversation mère en applique trois : des briefs bornés plutôt que des échanges qui s'étirent, le modèle qui suffit pour chaque tâche, un contexte qu'on referme au lieu de le laisser enfler. C'est la version individuelle de ce que le label demanderait aux applications.
Le cinquième critère conditionne les autres. La transparence, c'est que chaque fournisseur publie, pour chaque modèle, l'énergie consommée par token lu, par token écrit et par token relu en cache, indépendamment de ce qu'il facture. Car le prix n'est pas une mesure. Une lecture en cache est facturée de 10 à 40 fois moins cher qu'un token d'entrée selon le modèle ; elle consomme sans doute moins, puisque le modèle n'a pas à refaire le calcul, mais personne ne sait de combien, ni ce que coûte le stockage de ce cache en mémoire en attendant d'être relu. Les 8 % que j'ai utilisés viennent d'un projet open source, pas du fournisseur. Sans ces chiffres, chacun en est réduit, comme je l'ai fait ici, à des estimations construites sur des proxys, et aucun des quatre autres critères ne peut être vérifié. Ce devrait être la première exigence imposée à tout fournisseur qui prétend à une étiquette verte. Et la question vaut pour chaque éditeur : vos applications sont-elles conçues pour consommer le moins de données possible ?
En attendant, chacun peut agir à son échelle. Dire merci à son IA n'est pas le problème. Le problème, c'est la conversation qu'on ne referme jamais. Ne gaspillons pas la data de notre cerveau, ni celle de l'IA.
Sources
- Calculateur de coûts et d'empreinte des modèles d'IA (facteurs EcoLogits, CC BY-SA 4.0, et claude-carbon, MIT)
- EcoLogits et claude-carbon
- Liu et al., "Lost in the Middle: How Language Models Use Long Contexts" (TACL)
- Chroma, "Context Rot" (Hong, Troynikov, Huber, 14 juillet 2025)
- Modarressi et al., "NoLiMa: Long-Context Evaluation Beyond Literal Matching" (ICML 2025)
- Rodionov, Garipov, Yakushev, "Reasoning Shift: How Context Silently Shortens LLM Reasoning" (arXiv, 2026)
- Anthropic, "How we built our multi-agent research system"
- ADEME, communiqué sur l'avis IA générative (22 juillet 2026)
- Open University, "Sustainability of Generative AI"
- Queen Mary University of London, "Teaching with generative AI"
- Guide "Understanding AI Without Becoming Dependent on It" (label vert, chapitre 17)