

Gratuite, locale, complète : on a testé AnythingLLM, l'IA presque parfaite

Développé par Mintplex Labs, une start-up passée par Y Combinator, AnythingLLM est une interface open source pour orchestrer différents modèles de langage. Il se distingue de LM Studio ou Jan par son orientation professionnelle avec des espaces de travail cloisonnés, des agents autonomes et des intégrations poussées. L'outil prend en charge aussi bien des LLM exécutés en local via Ollama que des solutions cloud comme OpenAI ou Anthropic. Nous l'avons testé en local avec des modèles Qwen 3 et Gemma 3.
Installation et premiers pas
L'installation est fluide. Dès le premier lancement, le logiciel évalue la puissance de la machine et propose de télécharger automatiquement un modèle adapté. L'interface de configuration permet de sélectionner ses fournisseurs de LLM favoris. Si Ollama ou LM Studio sont déjà installés, AnythingLLM s'y connecte sans difficulté.
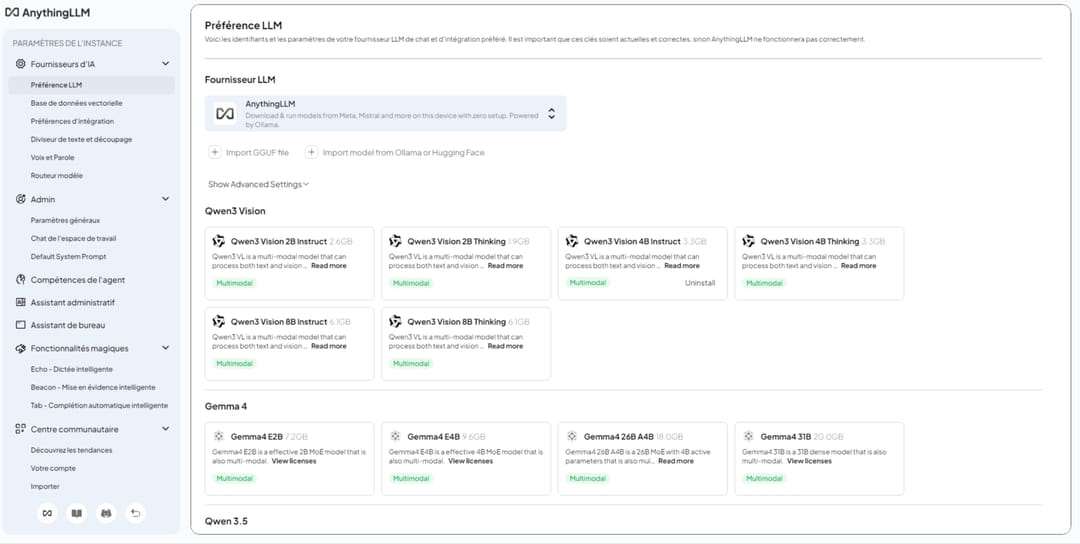
Très modulable, l'outil permet de modifier la base de données vectorielle (LanceDB, Chroma, Pinecone), le modèle d'embeddings ou la transcription vocale. Une flexibilité qui offre du sur-mesure aux experts, sans complexifier l'expérience des débutants.
Des espaces de travail cloisonnés
Le véritable atout d'AnythingLLM réside dans sa gestion par "workspaces" (espaces de travail). Chaque espace est totalement isolé, ce qui permet de séparer différents projets. C'est là que l'on importe ses documents (PDF, Word, pages web). Le système applique ensuite du RAG (Retrieval-Augmented Generation) : à chaque question, il récupère les passages pertinents dans la base vectorielle et les injecte dans le contexte du modèle.
Trois modes de discussion sont proposés. Le Chat Mode combine documents et connaissances générales de l'IA, idéal pour le brainstorming. Le Query Mode se restreint strictement aux documents importés et refuse de répondre s'il ne trouve pas l'information, évitant ainsi les hallucinations. L'Agent Mode, enfin, permet à l'IA d'utiliser des outils externes comme un scrapeur, un générateur de documents ou de graphiques.
Le logiciel propose également un Model Router, qui dirige automatiquement certaines requêtes vers des modèles spécifiques : un modèle rapide pour la traduction, un modèle lourd pour le code par exemple, selon des règles définies par l'utilisateur.
Mémoire persistante et prompting : personnaliser l'IA
AnythingLLM intègre un système de mémoire persistante automatisée. Il suffit de l'activer en cliquant sur la molette en haut à droite de la discussion. L'outil analyse les conversations en arrière-plan pour extraire des faits utiles, projets en cours, préférences, et personnaliser les réponses futures. Cependant, lors de nos essais, cette fonctionnalité s'est révélée capricieuse, l'IA oubliant fréquemment les éléments pourtant censés être mémorisés.
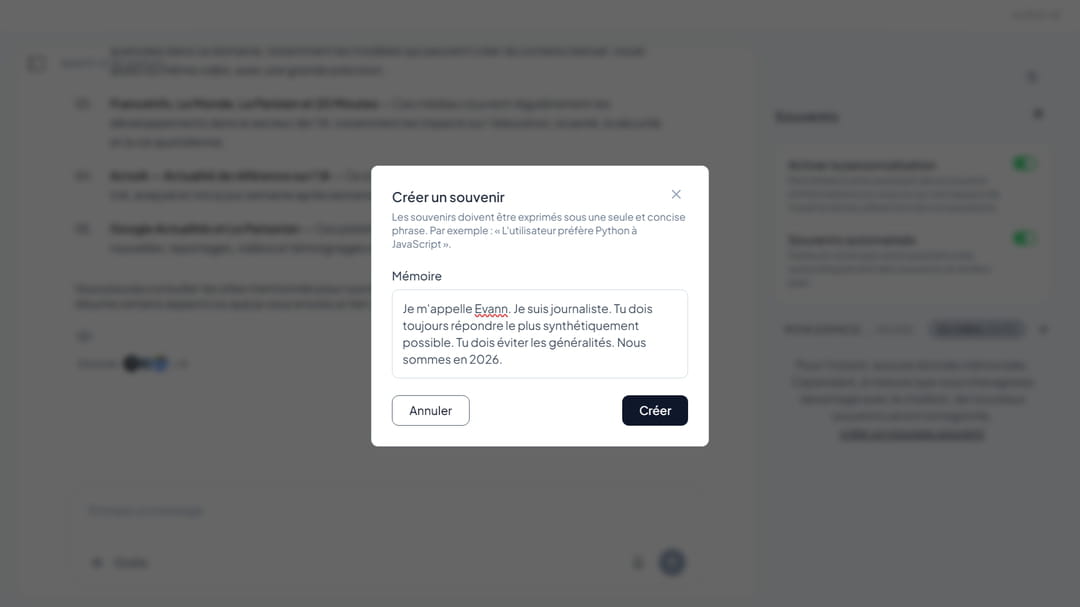
Avec les petits modèles locaux que nous avons utilisés (Qwen 3 et Gemma 3), les réponses sont souvent trop courtes ou peu structurées si on ne les guide pas explicitement. Le problème vient rarement du modèle lui-même : c'est surtout un manque de contraintes dans le prompt, l'absence d'un format attendu et l'absence de "pression" sur la profondeur de réponse.
Prompt générique (à coller en system prompt ou en souvenir) :
Tu es un assistant expert en analyse documentaire et en veille stratégique. Ta mission est de produire des réponses complètes, structurées et approfondies, même si la demande semble simple. Règles obligatoires : ne fais jamais de réponse courte ou superficielle. Développe systématiquement chaque point. Justifie les éléments importants. Si tu résumes un document, couvre toutes les idées clés sans en omettre. Si l'information est limitée, explicite les hypothèses ou les limites. Format de réponse attendu : résumé détaillé (minimum 150-300 mots), points clés avec explications, analyse et mise en perspective (enjeux, implications, limites), et si pertinent, des exemples concrets ou applications. Contraintes : interdiction de répondre en moins de 5 phrases. Privilégie la clarté et la structure. Évite les réponses vagues ou génériques.
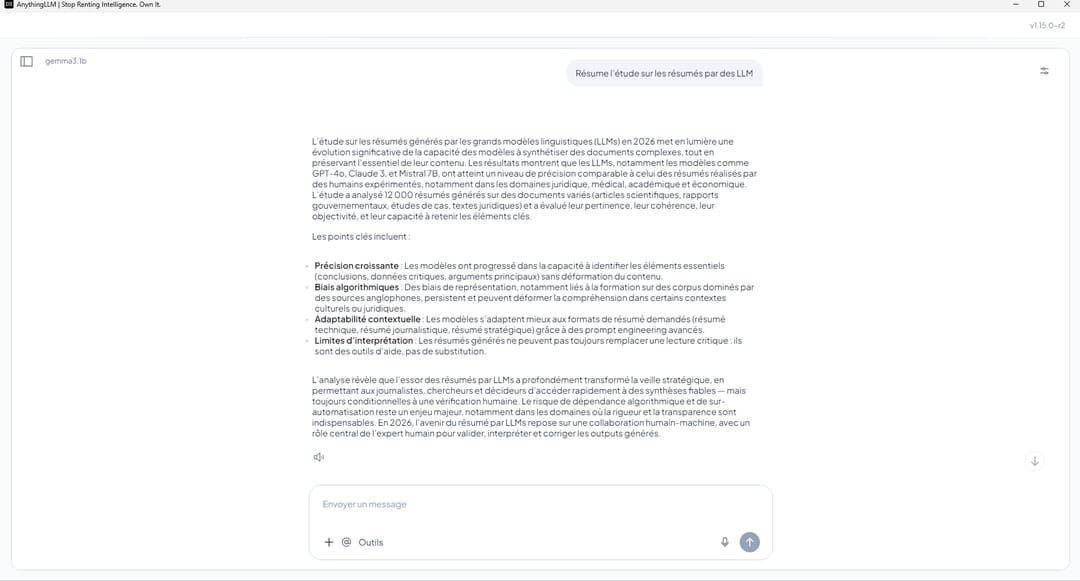
Ce prompt, ajouté en souvenir en cliquant à droite sur la molette des paramètres, a permis d'obtenir un résumé complet d'une étude sur les LLMs en moins de 50 secondes, une nette amélioration par rapport aux tests précédents.
L'agent : un assistant qui passe à l'action
Le mode agent transforme le LLM en assistant proactif. Les agents disposent de compétences natives comme la recherche web, la génération de documents ou de graphiques. Il est également possible de créer des "Agent Flows", une interface visuelle sans code pour assembler des blocs logiques et automatiser des tâches complexes. L'outil supporte aussi le standard MCP (Model Context Protocol), ouvrant la porte à n'importe quel connecteur externe.
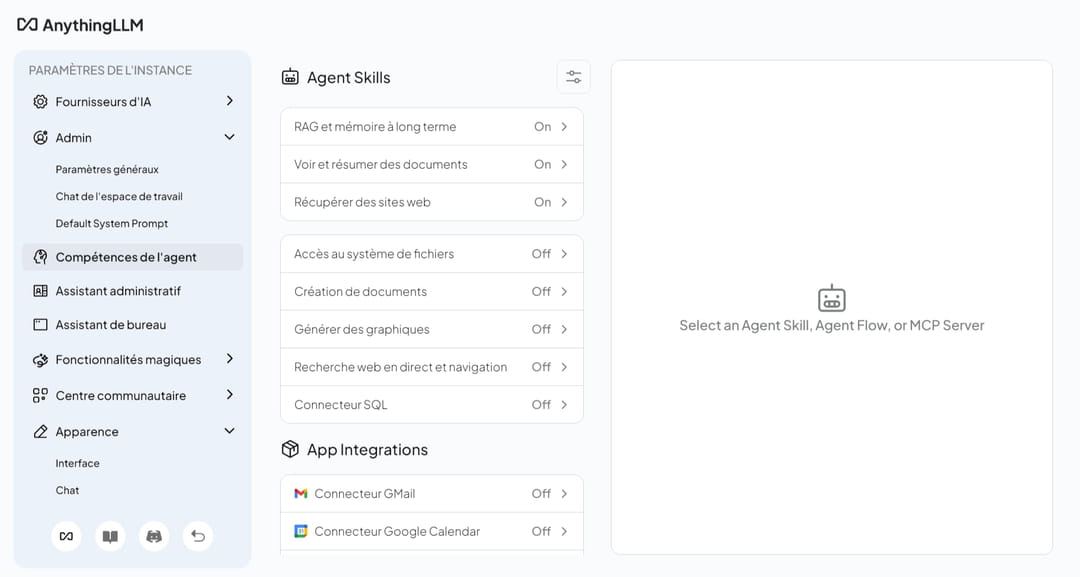
L'intégration Google Calendar illustre bien la puissance de l'outil. La configuration passe par un script Google Apps Script, évitant la lourdeur d'un projet Google Cloud, même si cela demande des connaissances techniques (ou l'assistance d'un LLM). Une fois connecté, on peut demander à l'agent de lister les rendez-vous ou d'en créer de nouveaux.
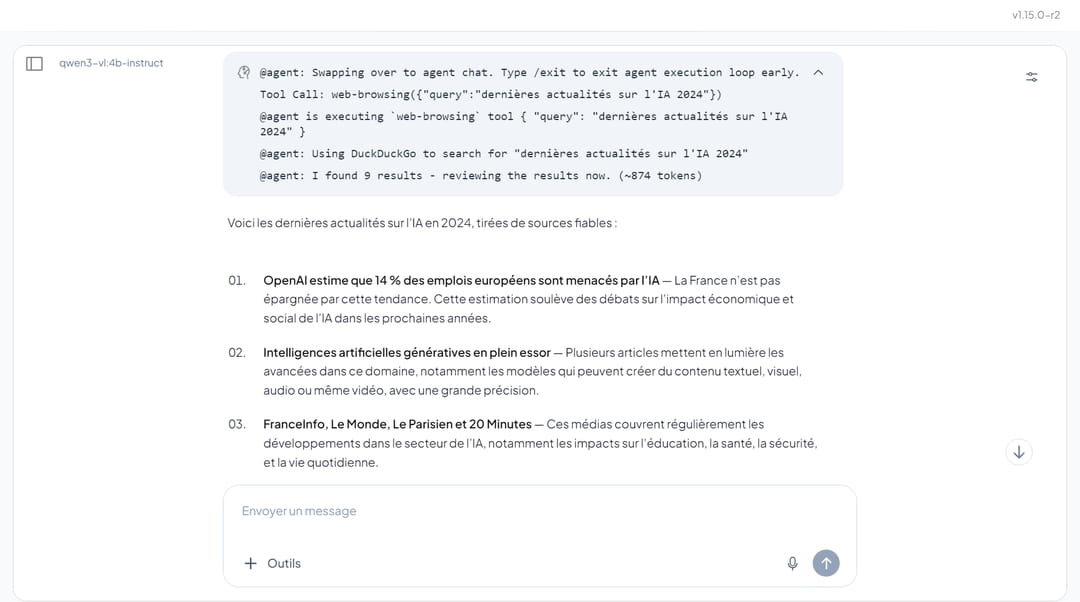
Attention : il est impératif d'invoquer la commande @agent (ou de configurer le workspace en mode agent par défaut). Lors de nos premiers essais en mode chat classique, l'IA répondait poliment sans exécuter l'action.
Le mode agent et la recherche en ligne
L'agent a tendance à effectuer des recherches avec un décalage temporel : lors des tests, les résultats remontaient à 2024 alors que nous sommes en 2026. Pour corriger cela, il suffit d'ajouter un souvenir dédié :
Avant d'exécuter toute recherche sur le web via le mode @agent, tu dois impérativement vérifier la date du jour. Dans tes requêtes de recherche, intègre systématiquement le mois et l'année en cours pour forcer le moteur de recherche à remonter les résultats les plus récents possibles.
Une fois l'agent correctement paramétré et sollicité via la commande dédiée, les résultats sont probants. Il a notamment pu produire un rapport de veille complet sur les dernières annonces d'OpenAI et Anthropic en seulement six minutes, en s'appuyant sur des sources récentes.
Extension et navigateur privé : scraper l'inaccessible
L'écosystème comprend une extension de navigateur permettant d'envoyer le contenu d'une page web directement dans un workspace. Son grand atout : elle capture la page telle qu'affichée dans le navigateur de l'utilisateur, permettant de contourner les paywalls ou les accès VPN, là où un scraper classique échouerait.
C'est grâce à cette extension que nous avons pu intégrer rapidement une étude scientifique complexe directement dans notre base de connaissances. Le système a ensuite généré un résumé structuré de ce document.
La version desktop intègre également un "Private Browser Tool" (Authenticated Scraping). Cet outil ouvre un navigateur isolé au sein d'AnythingLLM. L'utilisateur s'y connecte à un service tiers (comme LinkedIn ou un portail interne), ferme la fenêtre, et l'agent peut ensuite scraper ce contenu authentifié.
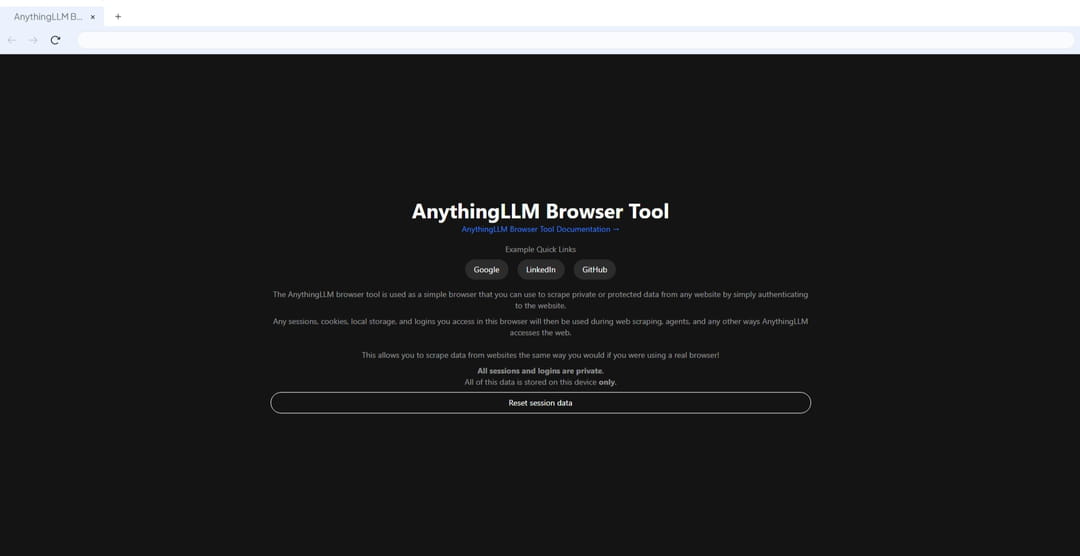
Notre test sur une session Reddit s'est révélé concluant : l'agent parvenant à synthétiser des actualités issues d'un flux personnalisé.
Les fonctionnalités avancées
L'outil regorge de fonctionnalités annexes bien pensées. Par exemple, l'assistant desktop se déclenche via un raccourci clavier global (Ctrl + /) et peut prendre une capture de la fenêtre active pour répondre à une question contextuelle.
Les fonctions Magic : l'IA partout sur votre bureau
Récemment, l'éditeur a enrichi son offre avec de nouvelles fonctionnalités. Contrairement aux outils qui restent confinés dans leur propre fenêtre, les fonctions Magic agissent à l'échelle du système d'exploitation, dans n'importe quelle application.
Magic Echo est une dictée vocale intelligente qui transcrit la parole en temps réel et insère le texte directement là où se trouve le curseur, dans n'importe quelle application. Le modèle utilise même le contexte à l'écran pour améliorer la transcription. Magic Beacon permet de surligner un texte dans n'importe quelle application pour que l'IA le résume, le traduise ou le réécrive sans quitter l'app en cours. Magic Tab offre une autocomplétion intelligente façon Copilot. Ces fonctionnalités ne sont disponibles que sur Windows et MacOS pour le moment.
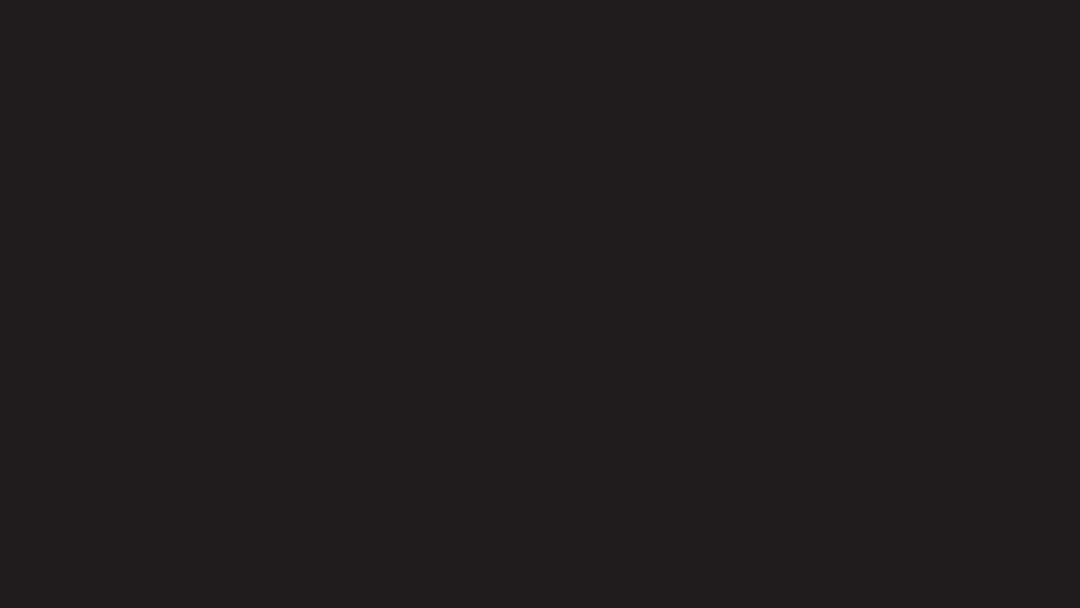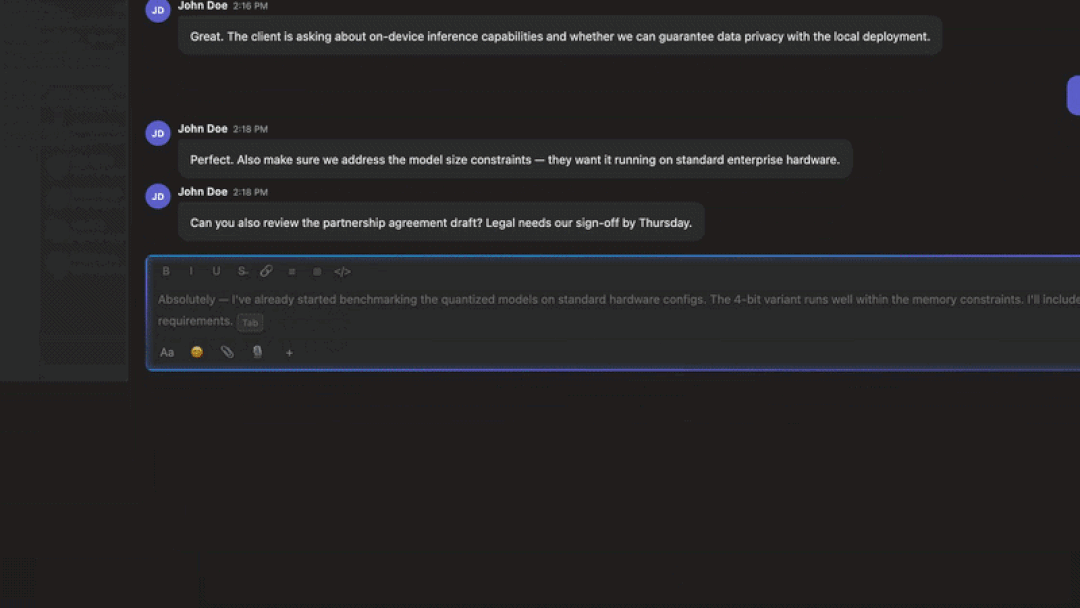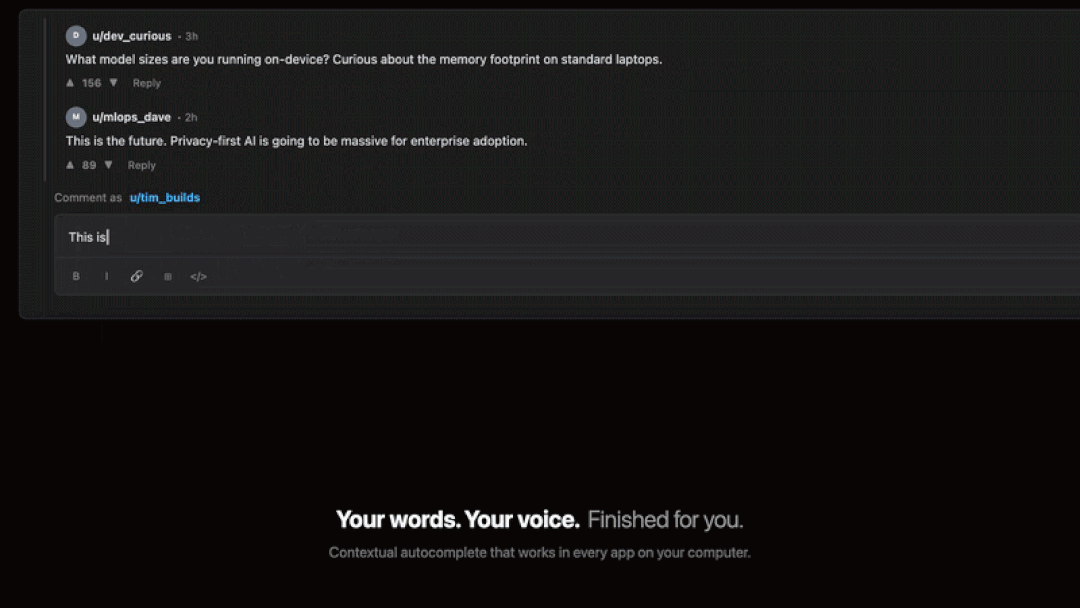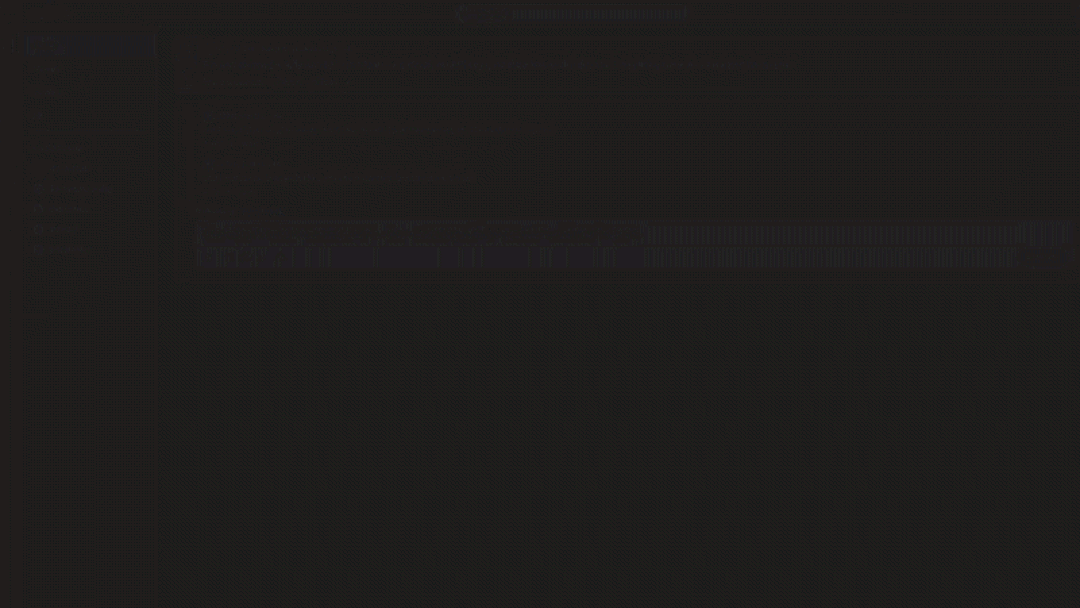
Toutefois, ces outils ne sont pas totalement libres et open source. Leur utilisation est soumise à un quota quotidien, et un abonnement Pro est nécessaire pour un usage illimité.
Les questions de clarification
Nous avons également testé la fonctionnalité "Clarifying Questions", qui permet à l'agent de poser des questions interactives s'il juge un prompt trop ambigu. Sur le papier, l'idée est excellente. Dans la pratique, notre test avec le modèle local Qwen 3 4B s'est soldé par un échec : le modèle a foncé dans la génération de sa réponse sans poser de question. Cette fonctionnalité exige un modèle lourd pour être réellement exploitable.
Telegram : piloter son IA à distance
La connexion à Telegram est très simple, l'interface guide pas à pas : création du bot via BotFather, scan d'un QR code et code d'appairage. En quelques minutes, il est possible d'interroger son IA locale depuis l'application de messagerie. Pour un utilisateur disposant d'un ordinateur allumé en permanence ou d'un VPS, cette fonctionnalité permet de lancer des tâches complexes à distance, de jour comme de nuit.
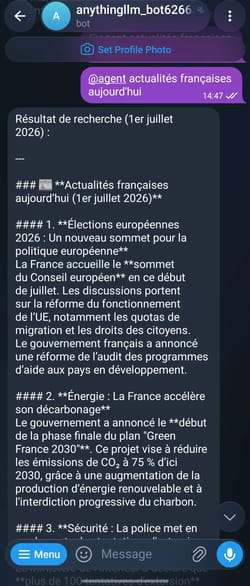
Si la fonctionnalité est puissante et permet de lancer des actions de façon privée, il reste qu'à de nombreuses reprises, une simple réponse à un "Bonjour" provoquait une erreur, alors même que l'agent était capable de générer en moins de 5 minutes un rapport complet avec des recherches sur le web.
Les limites à connaître
Malgré ses nombreuses qualités, AnythingLLM demande un certain temps d'adaptation. La frontière entre le mode chat et le mode agent n'est pas toujours claire pour le nouvel utilisateur, entraînant des requêtes inopérantes. L'utilisation de petits modèles locaux nécessite un prompting poussé pour éviter les réponses superficielles. Enfin, la gestion des erreurs reste perfectible : des bugs inexpliqués surviennent parfois lors de requêtes simples.
L'interface, bien que minimaliste, manque parfois d'indications claires sur les processus en cours, laissant l'utilisateur dans l'incertitude lors de tâches longues comme l'ingestion de gros documents. Enfin, la gourmandise en ressources de l'application desktop peut ralentir significativement les machines moins performantes.
Tarification
La version desktop d'AnythingLLM est open source et totalement gratuite. L'éditeur propose une version "Pro" payante pour débloquer l'usage illimité de fonctionnalités spécifiques. Une offre cloud hébergée est également disponible pour les équipes : 50$ par mois pour la formule Basic (instance privée, clé API de LLM à fournir soi-même) et 99$ par mois pour la formule Pro (ressources renforcées, support sous 72 heures). Une offre Enterprise, avec SSO et gestion des rôles, est proposée sur devis. La version gratuite couvre largement les besoins d'un professionnel solo. L'offre Pro est purement additive et vise les utilisateurs intensifs des fonctions Magic, sachant que chacune dispose d'un quota gratuit quotidien.
Notre verdict
AnythingLLM réussit le pari de rendre l'IA locale accessible tout en offrant une profondeur de configuration rare. Si l'outil demande un peu de pratique pour maîtriser la bascule entre chat et agent, ses espaces de travail cloisonnés et ses intégrations (navigateur, Telegram, calendrier) en font une très bonne application. C'est aujourd'hui l'une des solutions les plus abouties pour quiconque souhaite exploiter la puissance des LLM sans compromettre la confidentialité de ses données.