
Tokens des agents IA : le plafond est dans la boucle

Une expérimentation montre que le plafond des économies de tokens vient de la boucle agentique : les hooks réduisent les sorties d'outils, mais peuvent corrompre le résultat sans contrôle.
Optimiser les tokens d'un agent exige de contrôler la boucle qui construit son historique, sans dégrader le résultat fonctionnel.
Tout est parti d'un nombre : 98,2 %. Sur une semaine de travail réel, cette part du volume de tokens observé dans mes journaux Claude Code provenait de lectures du cache de prompts.
Ce chiffre ne signifiait pas que 98,2 % des données étaient inutiles. Il montrait que l'entrée dominante était déjà calculée et relue à tarif réduit. Il posait cependant une question plus précise : parmi toutes les informations réémises au modèle, quelle proportion restait réellement nécessaire à l'accomplissement de la tâche ?
Je pensais chercher une meilleure consigne pour réduire le contexte d'un agent IA. L'expérimentation a révélé un problème plus profond : depuis l'intérieur d'un harnais agentique géré — ici Claude Code — une partie majeure de l'historique est hors d'atteinte pour une extension.
Au départ, le problème paraissait relever du prompt engineering. Il devait être possible, pensais-je, de demander à un agent de mieux distinguer ce qui mérite d'être conservé de ce qui ne constitue qu'un résultat intermédiaire devenu inutile.
L'idée était simple : classer l'information dès sa création, conserver durablement les contraintes, les décisions ou les faits vérifiés, et empêcher les sorties d'outils périssables d'entrer inutilement dans l'historique.
Après 27 runs exploitables, la conclusion est différente. Le principal plafond n'est pas dans le prompt. Il se trouve dans l'architecture de la boucle agentique et dans le degré de contrôle qu'elle accorde à l'utilisateur.
Pourquoi les sorties d'outils coûtent-elles autant ?
Dans une boucle agentique, un résultat d'outil n'est pas seulement consommé une fois. Une lecture de fichier, une sortie de terminal ou un patch peut être réinjecté dans le contexte à chaque appel suivant.
La mesure a été faite par rejeu hors ligne des transcriptions locales d'un seul projet de développement : 16 sessions, 2 618 appels d'API, 3 073 résultats d'outils, 864 745 067 tokens d'entrée cumulés, soit environ 330 000 par appel.
Sur ce corpus, 8 665 429 octets bruts de résultats d'outils ont représenté 1 312 403 581 octets dans le contexte cumulé. Le rapport entre volume cumulé et volume brut est donc d'environ 151. Ce facteur caractérise ce workload précis ; il ne constitue pas une propriété universelle de Claude Code.
Ce phénomène explique pourquoi le cache, même lorsqu'il réduit le prix unitaire d'une relecture, ne supprime pas le problème de volume. Un token relu reste un token traité. Sur un forfait soumis à des limites de calcul, la différence entre coût financier et consommation de capacité devient essentielle.
La question n'est donc pas seulement : "Combien coûte ce token ?" Elle est aussi : "Pourquoi continue-t-il à circuler alors qu'il n'est plus utile ?"
Le point d'interception existe, mais il est limité
Claude Code expose un mécanisme pertinent : le hook PostToolUse, associé à updatedToolOutput. Il permet de remplacer le résultat d'un outil avant que celui-ci soit présenté au modèle et enregistré dans la conversation.
C'est précisément le point d'interception recherché.
Dans notre expérimentation, le contenu brut est déposé dans un stockage externe. À sa place, l'agent reçoit une référence courte contenant l'identifiant du résultat, sa taille, son empreinte cryptographique et la procédure permettant de le récupérer.
Une sonde contrôlée, réduite à quatre appels d'outils, a confirmé que le mécanisme fonctionnait sur Read, Edit et Write :
- 219 160 octets ont été externalisés ;
- les références de remplacement représentaient 1 018 octets ;
- 4 522 octets ont été récupérés explicitement par l'agent ;
- 213 620 octets ont donc été écartés du chemin immédiat.
La vérification a porté sur la transcription elle-même : les charges externalisées n'y figurent pas, à l'exception de ce que l'agent a explicitement rapatrié. Ce résultat établit qu'une substitution avant stockage est techniquement possible dans Claude Code.
Mais il révèle aussi la frontière du système.
Une limite architecturale, pas une faiblesse du prompt
Le hook PostToolUse ne contrôle que les résultats d'outils. Il ne permet pas de transformer librement le tableau complet des messages avant chaque requête.
Dans l'architecture documentée de Claude Code, aucun hook ne permet notamment :
- de réécrire un message déjà produit par l'assistant ;
- d'écarter sélectivement un bloc tool_use ;
- de transformer l'ensemble de l'historique avant son envoi au modèle ;
- de fournir son propre mécanisme complet de compaction ;
- de décider, bloc par bloc et hors résultats d'outils, ce qui ne doit jamais entrer dans l'historique.
Sur le projet étudié, la répartition du contenu cumulé des transcriptions est la suivante : les résultats d'outils en représentent 48,9 %, les blocs tool_use 15,6 %, et le texte de l'assistant avec les prompts 35,5 %.
Ce contenu reconstituable depuis les transcriptions représente lui-même environ 78 % des tokens d'entrée facturés — estimation obtenue en convertissant les octets en tokens au ratio usuel de quatre pour un, et qui vaut donc comme ordre de grandeur, non comme mesure exacte. Le reste, environ 22 %, est constitué du prompt système et des définitions d'outils.
Rapporté aux tokens d'entrée, cela donne quatre territoires :
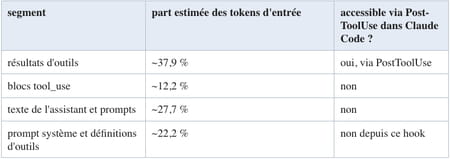
Le plafond du levier PostToolUse est donc d'environ 37,9 % des tokens d'entrée sur ce workload précis. Ce n'est pas une promesse de réduction : c'est la taille maximale du territoire accessible par ce mécanisme.
Les quarante pour cent situés dans les blocs tool_use et le texte de l'assistant ne peuvent pas être gouvernés par ce hook, quelle que soit la qualité du classifieur ou du prompt utilisé. Le prompt système et les définitions d'outils ne sont pas davantage accessibles depuis PostToolUse. Ils deviennent toutefois configurables lorsqu'un client construit lui-même la requête API. Le banc expérimental, tant qu'il reste à l'intérieur de Claude Code, ne peut donc pas tester l'hypothèse sur l'intégralité de l'historique.
Ce segment n'est pas accessible au hook, mais il est mesurable et se règle sans écrire une ligne de code. Sur la même machine, j'ai comparé le préfixe de première requête — avant que la conversation n'accumule quoi que ce soit — entre deux types de sessions. Les sessions du banc expérimental, volontairement dépouillées, affichent environ 3 500 à 5 300 tokens sur 62 observations. Les sessions de mon projet principal, observées du 28 août au 9 septembre, en affichent environ 35 000 sur 13 observations. L'écart atteint donc près de 30 000 tokens dès la première requête de la session.
La composition exacte de cet écart reste à établir. Les deux fichiers d'instructions, celui du projet et celui de l'utilisateur, en représentent moins de 2 000 tokens. Le reste semble tenir principalement aux serveurs d'outils déclarés et aux extensions chargées. Comme ce préfixe est ensuite mis en cache, sa lecture est facturée à une fraction du prix d'entrée — généralement 0,1 fois selon le modèle — : l'impact financier réel est donc inférieur au volume brut. Tarification officielle du prompt caching.
Il reste que ce segment, que le hook ne peut pas gouverner, est le seul que l'on puisse réduire depuis Claude Code par configuration plutôt que par mécanisme d'interception.
Cette observation rejoint le prompt diffusé par le JDN dans sa newsletter du 14 septembre 2026, intitulé "Pour auditer les skills et MCP à supprimer dans votre agent de code". Il commence par une consigne qui résume exactement la discipline nécessaire : "Audite ta propre configuration. Tu es lancé dans ce repo, tu as accès au shell : va lire les fichiers, ne déduis rien de mémoire." Le prompt demande ensuite de distinguer ce qui est déclaré de ce qui est actif, de mesurer ce qui est toujours injecté par rapport à ce qui n'est chargé qu'à l'invocation, et de croiser l'inventaire avec les traces d'usage. Il est rattaché au Guide des prompts du JDN.
C'est la véritable découverte : ce que nous prenions pour une difficulté de formulation était une limite d'architecture.
Ce que l'expérimentation ne permet pas de mesurer
Il faut dire aussi ce que ce dispositif ne prouve pas, et pourquoi.
Le mécanisme fonctionne et son effet mécanique est mesurable : la sonde a écarté 213 620 octets du chemin immédiat. Ce qui n'a pas encore pu être estimé de façon robuste, c'est son effet causal sur la consommation totale. Sur les répliques disponibles — quatre à six runs par configuration, à modèle, fixture et prompts identiques — le coefficient de variation de la consommation totale va de 12 % à 31,5 % selon la configuration. La dispersion observée est donc du même ordre, voire supérieure, à l'effet recherché.
Or l'effet attendu du mécanisme se situe sous les vingt pour cent. Selon la dispersion retenue et la taille de l'effet recherchée, une estimation de puissance à 80 % conduit à un ordre de grandeur de douze à quatre-vingts runs par bras. À plusieurs millions de tokens le run, ce protocole serait disproportionné à ce stade du programme.
L'enseignement n'est pas mince : dans une boucle agentique, la trajectoire de l'agent varie assez d'un run à l'autre pour que la comparaison entre bras sur la consommation totale soit un instrument insuffisant lorsqu'elle est utilisée seule. Le volume transmis doit être mesuré à l'intérieur d'un même run, en comptant exactement les octets retenus et écartés avant chaque appel — ce qui suppose de contrôler la construction de la requête. Cette mesure résout l'axe du volume, mais ni la variabilité comportementale ni la préservation du résultat fonctionnel.
Réduire le volume ne suffit pas
La sonde a également produit un résultat plus important encore.
La tâche demandait de recopier intégralement un fichier d'environ 53,7 kilo-octets. Le hook a correctement remplacé son contenu par une référence. L'agent a alors récupéré seulement 4 096 octets, bien que la sortie structurée complète en comptât 54 272, puis il a écrit la référence elle-même dans le fichier de destination.
Le fichier final ne pesait que 339 octets. Il ne contenait aucune occurrence du contenu attendu.
Le mécanisme de réduction avait fonctionné, mais la tâche avait été silencieusement corrompue. Aucun contrôle ne l'a signalé.
La cause est instructive. La référence indiquait bien la taille totale de la charge. Ce qui manquait, c'était une procédure explicite de reconstruction : elle proposait un appel de récupération de 4 096 octets sans signaler qu'il fallait paginer pour couvrir les 54 272 octets. L'information était présente, mais l'interface de rappel n'indiquait pas comment reconstituer la charge complète.
Cette observation montre pourquoi la réduction de tokens ne peut jamais être évaluée seule. La valeur d'une architecture de gestion du contexte réside dans la position qu'elle atteint entre deux axes :
- le volume d'information inutile qui n'est plus propagé ;
- la capacité de l'agent à préserver les contraintes et à produire un résultat correct.
Écarter 99 % d'une charge n'a aucune valeur si l'agent ne sait pas la récupérer au moment où elle devient nécessaire. Une interface de rappel doit donc exposer la taille totale, la pagination nécessaire et un moyen de vérifier que la charge a été intégralement reconstruite. Pour certaines opérations exigeant l'intégralité d'un contenu, le mécanisme devrait peut-être refuser l'externalisation si la récupération complète ne peut pas être garantie.
Cette conclusion trouve un écho dans un autre article du JDN, consacré à Codebase-Memory, un MCP de type knowledge graph. Son benchmark, réalisé avec Codex sur le projet open source Wagtail rapporte deux résultats opposés : une hausse de 13 % pour une analyse large, mais une baisse de 45,6 % pour une recherche ciblée d'usages d'une méthode. Le résultat illustre la même conclusion que notre travail : un outil supplémentaire ne réduit le contexte que s'il remplace effectivement plusieurs lectures ; s'il vient simplement s'ajouter à l'exploration existante, il augmente la charge. Lire l'article du JDN sur Codebase-Memory.
Anthropic (et les autres fournisseurs par extension) empêche-t-il l'optimisation des tokens ?
Le système empêche de fait certaines formes d'optimisation depuis l'intérieur de Claude Code. Il serait toutefois excessif d'en déduire qu'Anthropic cherche volontairement à maintenir une consommation élevée.
Les éléments disponibles ne démontrent aucune intention de ce type.
Claude Code fournit au contraire un hook permettant de remplacer les sorties d'outils. Le produit propose également la compaction, l'isolation par sous-agents et plusieurs mécanismes de gestion du contexte. L'API Messages permet par ailleurs de construire sa propre boucle lorsque l'application a besoin de contrôler directement l'historique transmis au modèle.
L'explication la plus prudente est structurelle. Les messages de l'assistant et les blocs tool_use constituent la trace produite par le modèle lui-même. Les modifier rétroactivement peut rompre la cohérence de la conversation et perturber les mécanismes de cache, qui reposent sur la stabilité du préfixe. On remarquera d'ailleurs que le seul point d'interception exposé, PostToolUse, est aussi le seul endroit de la boucle où du contenu entre dans l'historique sans avoir été produit ni par le modèle ni par l'utilisateur.
La formulation honnête est donc la suivante : Claude Code ne permet pas à une extension exécutée dans sa boucle de gouverner l'intégralité de l'historique. Il ne s'agit pas d'une preuve d'intention, mais bien d'une restriction technique ayant un effet concret sur la capacité d'optimisation.
Reprendre le contrôle du tableau de messages
Pour dépasser le plafond de Claude Code, une autre architecture est nécessaire.
Dans une boucle manuelle construite autour de l'API Messages, le client reçoit les blocs tool_use, exécute les outils, construit les blocs tool_result et choisit l'historique transmis à l'appel suivant. Le tableau messages devient alors contrôlable avant chaque requête.
Le Tool Runner peut automatiser cette boucle, l'exécution des outils et la gestion de l'état. Il ne faut toutefois pas le confondre avec un hook général de transformation de l'historique : Anthropic recommande la boucle manuelle lorsque l'application a besoin d'une approbation humaine dans la boucle, d'une journalisation personnalisée ou d'une exécution conditionnelle. Cette recommandation est directement pertinente ici : l'admission ou le refus d'une charge est une décision conditionnelle, et peut nécessiter une validation humaine lorsque l'intégrité du résultat prime sur l'économie de tokens. Documentation officielle du Tool Runner.
Sur le workload mesuré, une boucle appartenant au client rendrait théoriquement gouvernable la partie reconstituable de l'historique : résultats d'outils, blocs tool_use, textes de l'assistant et prompts, soit environ 78 % des tokens d'entrée selon l'approximation utilisée. Le prompt système et les définitions d'outils deviennent eux aussi configurables par le client, même s'ils restent nécessaires au fonctionnement de l'agent.
Ce chiffre de 78 % ne constitue pas une réduction attendue. Il décrit un territoire sur lequel une politique peut intervenir. Les contraintes de cohérence demeurent : un bloc tool_use ne peut pas être supprimé arbitrairement sans préserver sa relation avec le tool_result correspondant, et une décision ou une contrainte utilisateur ne doit pas disparaître au seul motif qu'elle occupe de la place.
Cette architecture supprime aussi une difficulté rencontrée plusieurs fois pendant l'expérimentation : un hook peut demander une substitution que l'hôte refuse silencieusement. Trois runs ont été perdus de cette façon, et il a fallu vérifier la transcription pour s'en apercevoir. Lorsque le client construit lui-même la requête, ce qui est écarté n'est effectivement pas envoyé et le volume transmis devient exactement observable. Cela ne supprime cependant ni la variabilité comportementale entre exécutions ni la nécessité de vérifier le résultat fonctionnel.
Le prix à payer est important. Il faut reconstruire l'orchestration, réimplémenter les outils, restaurer les garde-fous de sécurité et établir une nouvelle ligne de base. Les résultats obtenus sous Claude Code ne seront plus directement comparables, car l'agent et sa boucle d'exécution auront changé.
La fin du prompt engineering comme réponse universelle
Le principal enseignement n'est donc pas qu'un prompt particulier permettrait d'économiser un pourcentage déterminé de tokens.
Il est plus général : la gouvernance du contexte dépend d'abord de la propriété de l'historique.
Tant que l'on travaille à l'intérieur d'une boucle agentique dont on ne contrôle qu'un point d'interception, l'optimisation reste limitée à ce point. Aucune consigne, aussi sophistiquée soit-elle, ne peut agir sur les segments que l'architecture ne lui expose pas.
Claude Code autorise une optimisation réelle des sorties d'outils. Mais il impose également un plafond architectural à cette optimisation.
La découverte ne démontre pas qu'Anthropic veut empêcher la réduction des tokens. Elle démontre quelque chose de plus utile : pour optimiser l'ensemble du contexte, il ne suffit pas de mieux parler à l'agent. Il faut posséder la boucle qui construit ses messages.