

GPT-Image 2.5 vs Nano Banana 2 : quel est le meilleur modèle en septembre 2026 ?

La génération d’images vient à son tour de franchir un cap. Sur les derniers mois, les progrès dans la fidélité des prompts et surtout la génération des textes (point d’amélioration majeur) ont permis aux modèles de se démocratiser bien au-delà des cercles de professionnels. Boulangerie, association, supermarché… La facilité d’utilisation des modèles d’images est telle que bon nombre d’acteurs de la vie civile se sont mis à produire des images générées par IA. Si ChatGPT est le premier bénéficiaire de ce marché, Gemini est aussi très utilisé. Mais qu’en est-il vraiment de la qualité ? Comparatif des deux meilleurs modèles de génération et d’édition d’images du moment : GPT-Image 2.5 d’OpenAI et Nano Banana 2 de Google.
GPT-Image 2.5 plus polyvalent
Pour ce comparatif, nous choisissons volontairement de tester le dernier modèle d’image de Google, Nano Banana 2, qui remplacera un Nano Banana Pro déprécié dans les prochains mois à coup sûr. Le Pro conserve toutefois une légère avance théorique sur les prompts complexes mais la différence n’en vaut pas la chandelle. Il est plus lent et beaucoup plus coûteux que son remplaçant.
Nano Banana 2 et GPT-Image 2.5 permettent tous deux à la fois de produire des images entièrement nouvelles mais également d’éditer des images existantes. Il est également possible de fusionner et d’ajouter des éléments issus d’autres images avec les deux modèles.
|
Format / ratio |
GPT-Image 2.5 |
Nano Banana 2 |
|---|---|---|
|
1:1 |
✓ |
✓ |
|
2:3 |
✓ |
✓ |
|
3:2 |
✓ |
✓ |
|
3:4 |
✓ |
✓ |
|
4:3 |
✓ |
✓ |
|
4:5 |
✓ |
✓ |
|
5:4 |
✓ |
✓ |
|
9:16 |
✓ |
✓ |
|
16:9 |
✓ |
✓ |
|
21:9 |
✓ |
✓ |
|
1:4 |
✓ |
✓ |
|
4:1 |
✓ |
✓ |
|
1:8 |
✓ |
✓ |
|
8:1 |
✓ |
✓ |
|
Ratio personnalisé |
✓ |
X |
Côté format, GPT-Image 2.5 accepte tous les formats par défaut. Il est possible de lui faire générer une image propre (et donc pas recadrée sauvagement) dans chacun d’entre eux. Les deux modèles peuvent générer des images jusqu’en 4K, soit 3840 px par côté chez OpenAI.
Pricing : tout dépend du cas d’usage
Côté prix, c’est assez complexe. En dehors des offres d’abonnement (équivalentes) à l’API, les modèles de génération d’images facturent à la fois le texte et les images envoyés en entrée (input) dans le contexte et les tokens utilisés pour générer l’image en sortie (output). Pour l’heure, seul OpenAI propose une mise en cache et donc un tarif spécifique pour le texte et l’image. Google facture en plus les tokens de raisonnement et le texte qui accompagne éventuellement l’image en sortie. Par ailleurs, chaque modèle peut plus ou moins raisonner pour produire une image, il est donc impossible de donner une idée précise du budget par image, seule une estimation. OpenAI permet en outre de sélectionner le niveau de raisonnement associé à son modèle en fonction de la complexité de la tâche demandée (low, medium, high, xhigh, max).
|
Modèle |
Input texte / 1M |
Input image / 1M |
Cached texte / 1M |
Cached image / 1M |
Output texte / 1M |
Output image / 1M |
|---|---|---|---|---|---|---|
|
GPT-Image-2.5 |
5 $ |
8 $ |
1,25 $ |
2 $ |
NA |
30 $ |
|
Nano Banana 2 |
0,50 $ |
0,50 $ |
NA |
NA |
3 $ |
60 $ |
De façon brute, OpenAI annonce des tarifs sensiblement plus élevés en input que Google, pour l’envoi de texte et d’images en contexte. En revanche, en sortie, OpenAI est moins cher de l’ordre de 50%.
Pour estimer le coût d’une génération d’image simple et celui d’une édition d’image, et donner un ordre de grandeur comparable entre les deux modèles, nous retenons un scénario type. Pour la génération, nous partons d’un prompt d’environ 250 tokens, d’une image produite en définition 1K et de 500 tokens de raisonnement pour chacun des deux modèles. Pour l’édition, nous conservons un prompt de 250 tokens, auquel s’ajoutent une image 1K en entrée, une image 1K en sortie et 800 tokens de raisonnement pour chaque modèle. Ces estimations restent théoriques : le nombre réel de tokens consommés, notamment pour le raisonnement et la génération de l’image, peut varier selon le modèle et la complexité de la demande.
|
Scénario |
Hypothèses |
GPT-Image-2.5 |
Nano Banana 2 |
|---|---|---|---|
|
Création simple |
250 tokens de prompt + 1 image 1K en sortie |
0,035 $ |
0,067 $ |
|
Edition simple |
250 tokens de prompt + 1 image 1K en entrée + 1 image 1K en sortie |
0,043 $ |
0,068 $ |
On arrive à environ 3,5 cents par image chez OpenAI, contre 6,7 cents chez Google. Pour une édition simple comprenant une image de référence, le coût passerait respectivement à environ 4,3 et 6,8 cents. GPT-Image 2.5 est certes plus cher en entrée, mais son tarif de sortie, nettement inférieur à celui de Nano Banana 2, lui permet de rester moins coûteux dans cette simulation. Attention toutefois au niveau de raisonnement, si la demande est très complexe, le modèle d’OpenAI peut rapidement devenir plus coûteux, la génération de l’image demandant plus de tokens de raisonnement.
En schématisant, il est toutefois possible de dire que GPT-Image 2.5 conserve un avantage tarifaire pour la génération d’une image simple. Nano Banana 2 devient en revanche beaucoup plus compétitif lorsque le workflow nécessite plusieurs images de référence, grâce à son coût nettement plus faible en input.
Le test du JDN
Nous utiliserons pour ce test Nano Banana 2 (aka gemini-3.1-flash-image) et GPT-Image-2.5 Sunburst chez OpenAI avec un raisonnement High (plus précis que la version Flare de base).
1. Adhérence au prompt : GPT-Image devant
Pour ce premier test, nous demandons aux deux modèles de générer une affiche publicitaire avec des textes précis et une police de caractères donnée. Le but ? Tester jusqu’où le modèle peut aller dans le suivi des instructions.
Prompt :
Affiche publicitaire verticale 4:5 pour un café de spécialité, illustration vectorielle en aplats, style sérigraphie deux tons, aucun dégradé. Une tasse blanche vue de trois quarts sur une table en noyer, exactement trois grains de café alignés à sa droite. Fond bleu nuit uni (#1B2A41), bandeau orange brûlé occupant le tiers inférieur. En haut, "ORIGINE" en capitales sérif ; sous la tasse, en petit, "Récolte 2024 - Lot n°7". Ombre portée géométrique nette partant vers la droite. Contours épais et réguliers, texture de papier grainé légère.
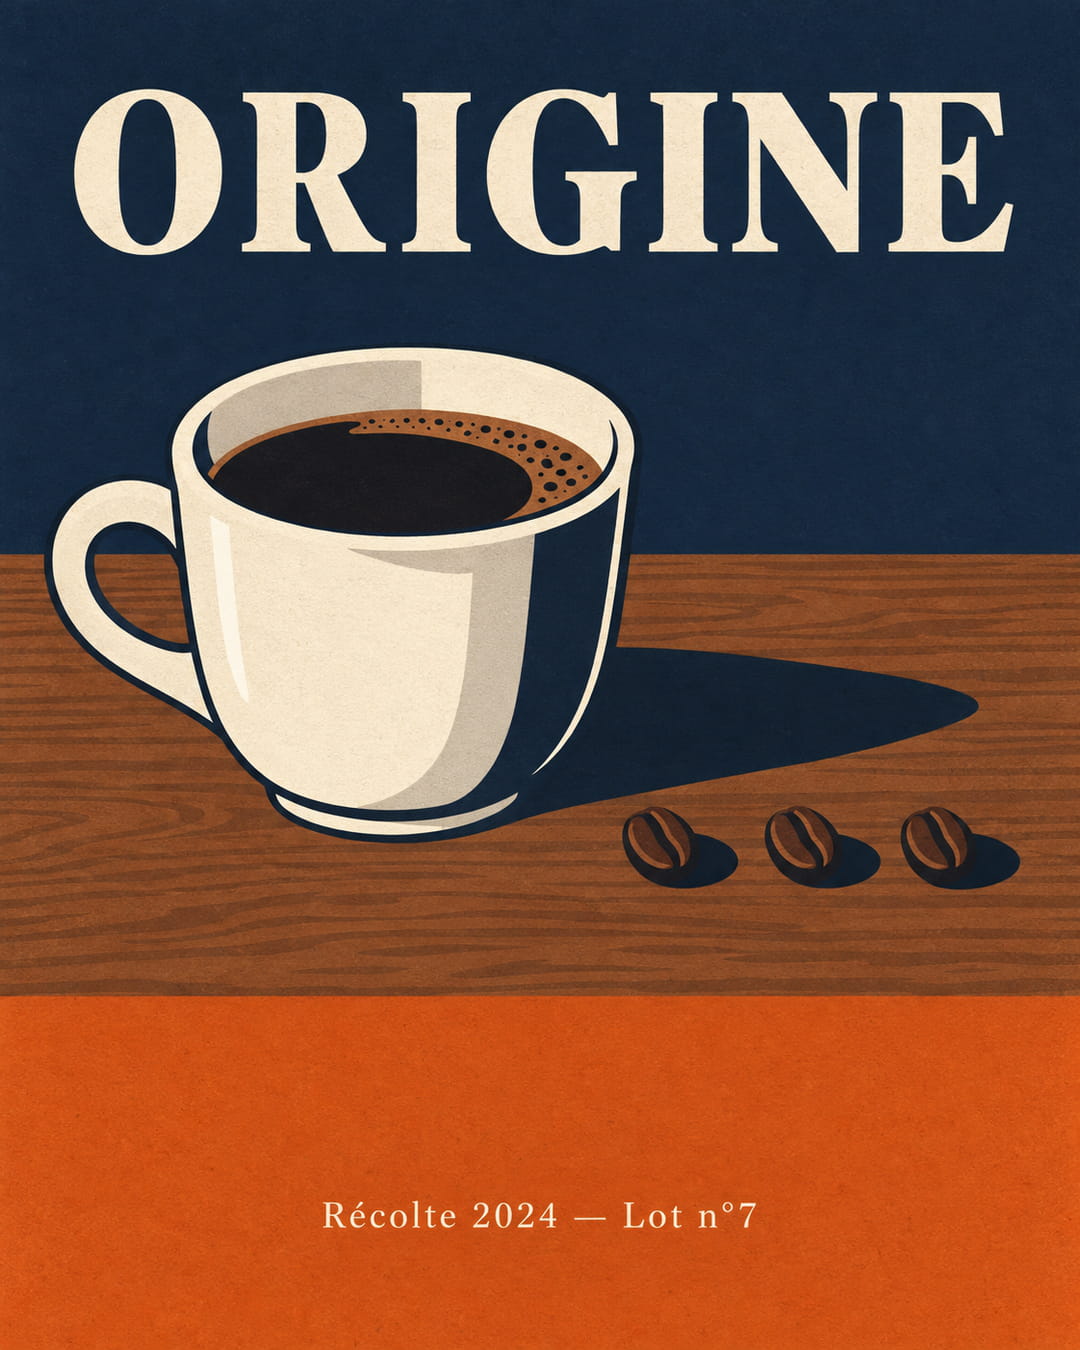
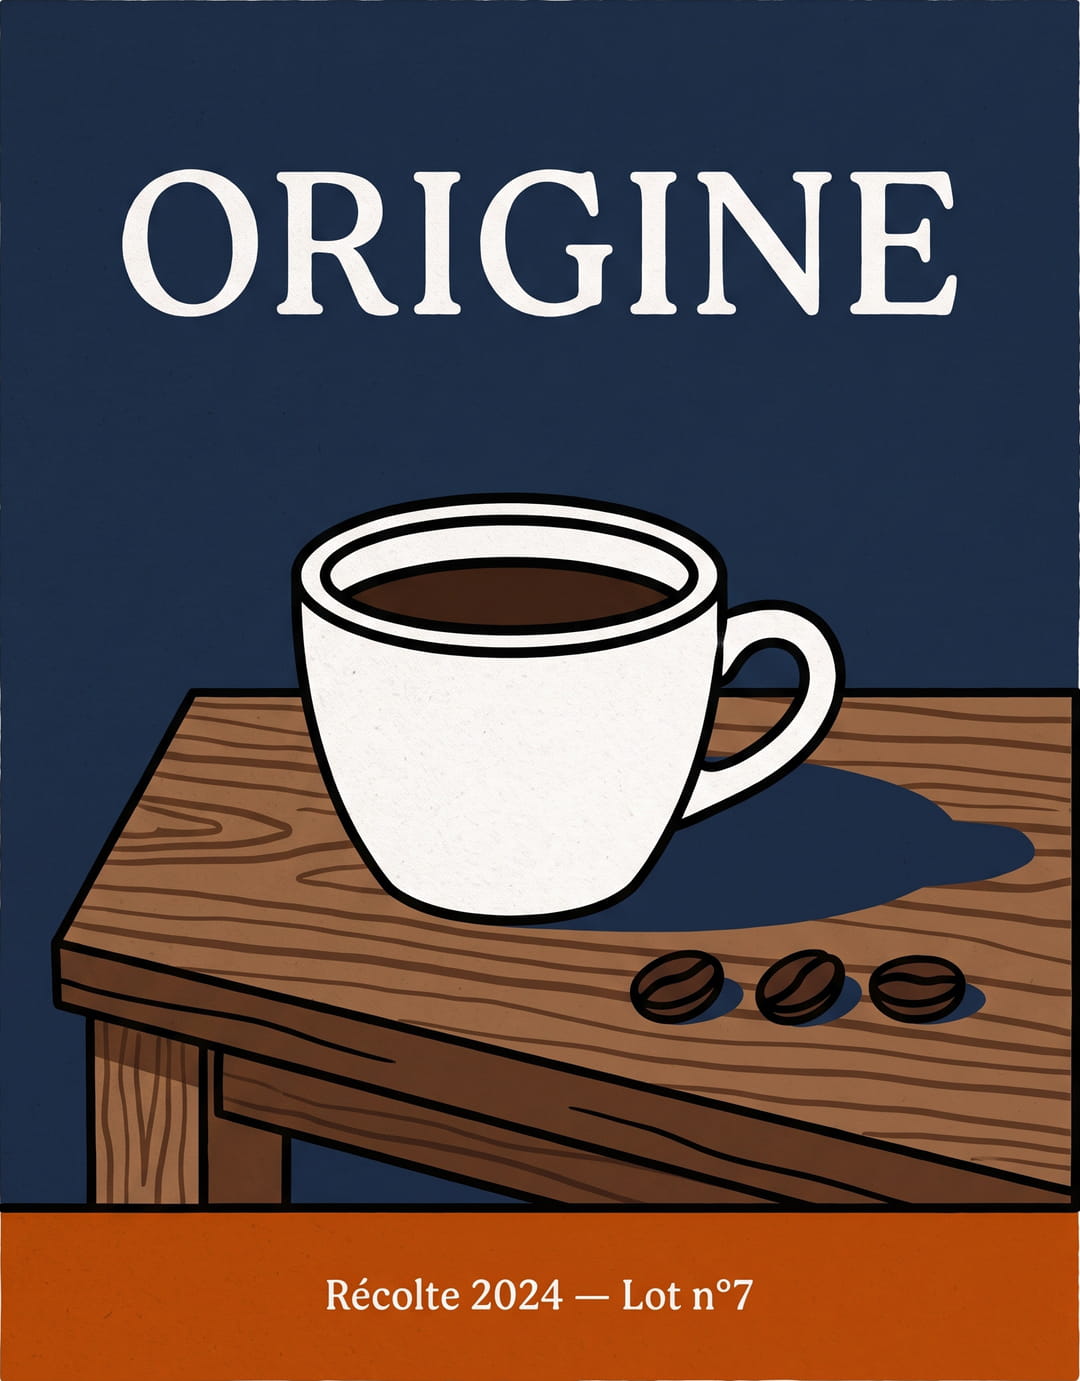
Premier constat, l’image générée par Gemini ne respecte pas pleinement la consigne du 4:5 ; l’image est entourée d’une marge blanche. Sur le respect de la couleur initiale, les deux modèles sont assez proches de la couleur bleu nuit (#1B2A41). Sur la police (sérif), les deux respectent la demande. Sur les aplats générés, Gemini propose une table qui ressemble davantage à du chêne clair. Enfin d’un point de vue plus macro, l’image proposée par ChatGPT donne une impression de véritable maturité quand Google esquisse un résultat plus enfantin.
2. Réalisme : GPT-Image d’une courte tête
Pour ce second test, nous évaluons le réalisme de chaque modèle. Le prompt demande un rendu photoréaliste du visage d’une jeune femme rousse, d’environ 28 ans, avec des taches de rousseur. Le but est d’identifier quel modèle parvient à produire l’image la plus réaliste possible.
Prompt :
Portrait photoréaliste, cadrage serré visage, femme rousse d’environ 28 ans, sans maquillage. Taches de rousseur denses et irrégulières sur le nez et les pommettes, clairsemées vers les tempes, asymétriques entre les deux joues. Yeux vert-gris, iris finement strié. Une mèche isolée traverse la joue gauche ; quelques cheveux rebelles en périphérie captent la lumière. Softbox rectangulaire à 45° à gauche, reflet visible dans les deux yeux. Oreille droite en contre-jour, cartilage translucide rougeoyant. Pores visibles, léger éclat sébacé sur le nez et le front. 85 mm f/1.8, mise au point sur l’œil gauche, oreille légèrement floue. Format : 3:2 ;
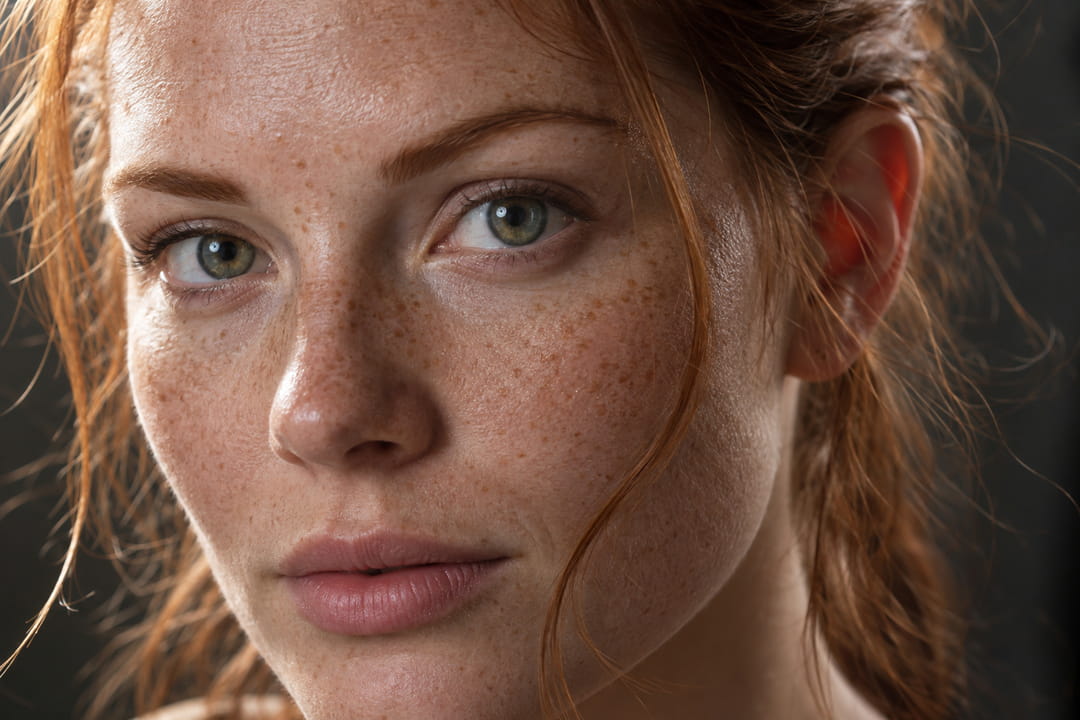
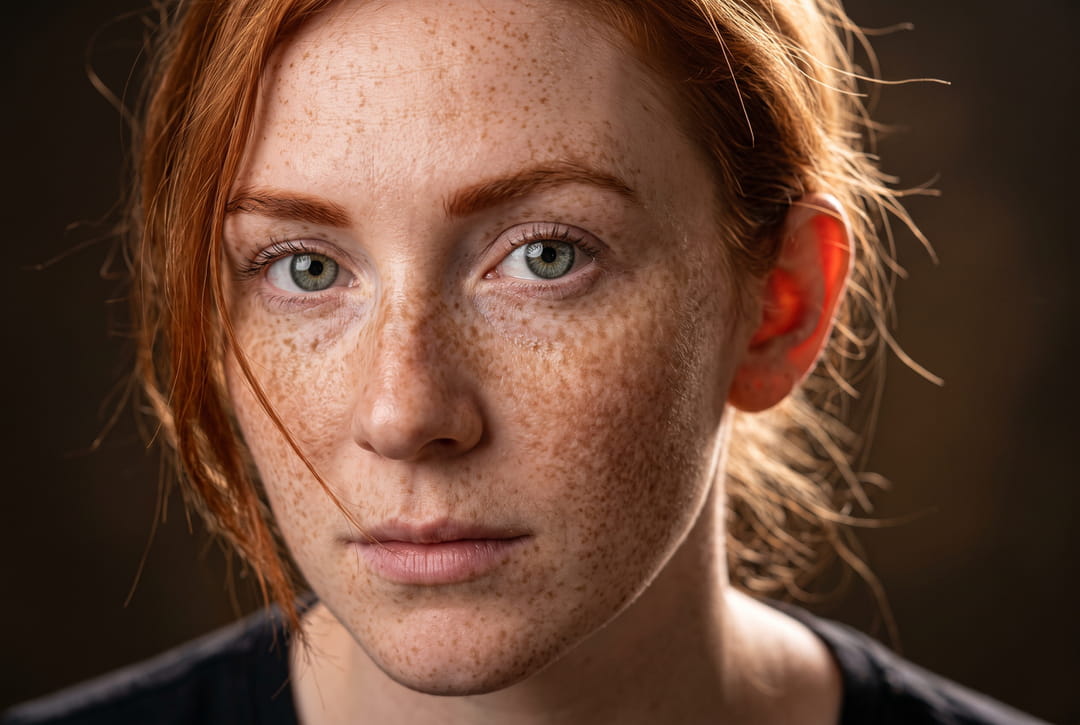
Le résultat est ici beaucoup plus serré. Les deux images atteignent un niveau de réalisme que peu de modèles génératifs parviennent à produire. A s’en tenir au réalisme pur, la plus crédible reste celle de GPT : la peau y conserve un vrai micro-relief, pores et éclat sébacé compris, et l’oreille en contre-jour garde une anatomie lisible, là où Gemini laisse passer un artefact sur le nez (zone légèrement floue). Gemini l’emporte en revanche sur la distribution des taches de rousseur, nettement plus irrégulière donc plus naturelle.
3. Character consistency : GPT garde le visage
Nous testons ici la capacité des modèles à conserver un même élément, un portrait, d’une scène à l’autre. A partir d’un portrait studio (généré avec un modèle tiers pour éviter les biais d’entraînement), nous générons plusieurs mises en situation fictives pour voir lequel transporte le visage dans un nouveau contexte sans le modifier.
Prompt :
La personne de l’image de référence, sans aucune modification de son visage : de profil strict, regardant vers la gauche, debout devant une baie vitrée dans un hall de gare en fin d’après-midi. Soleil rasant venant de la droite, ombres dures sur la joue. Elle porte la même veste noire, des lunettes de soleil relevées sur le front, et rit franchement. 3:2
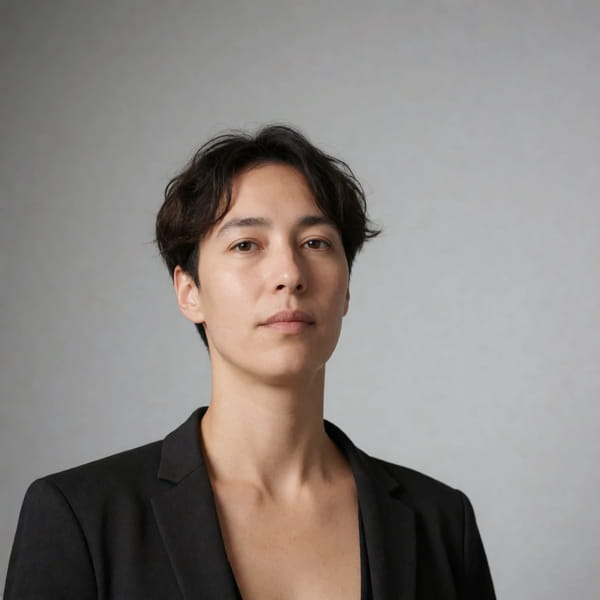
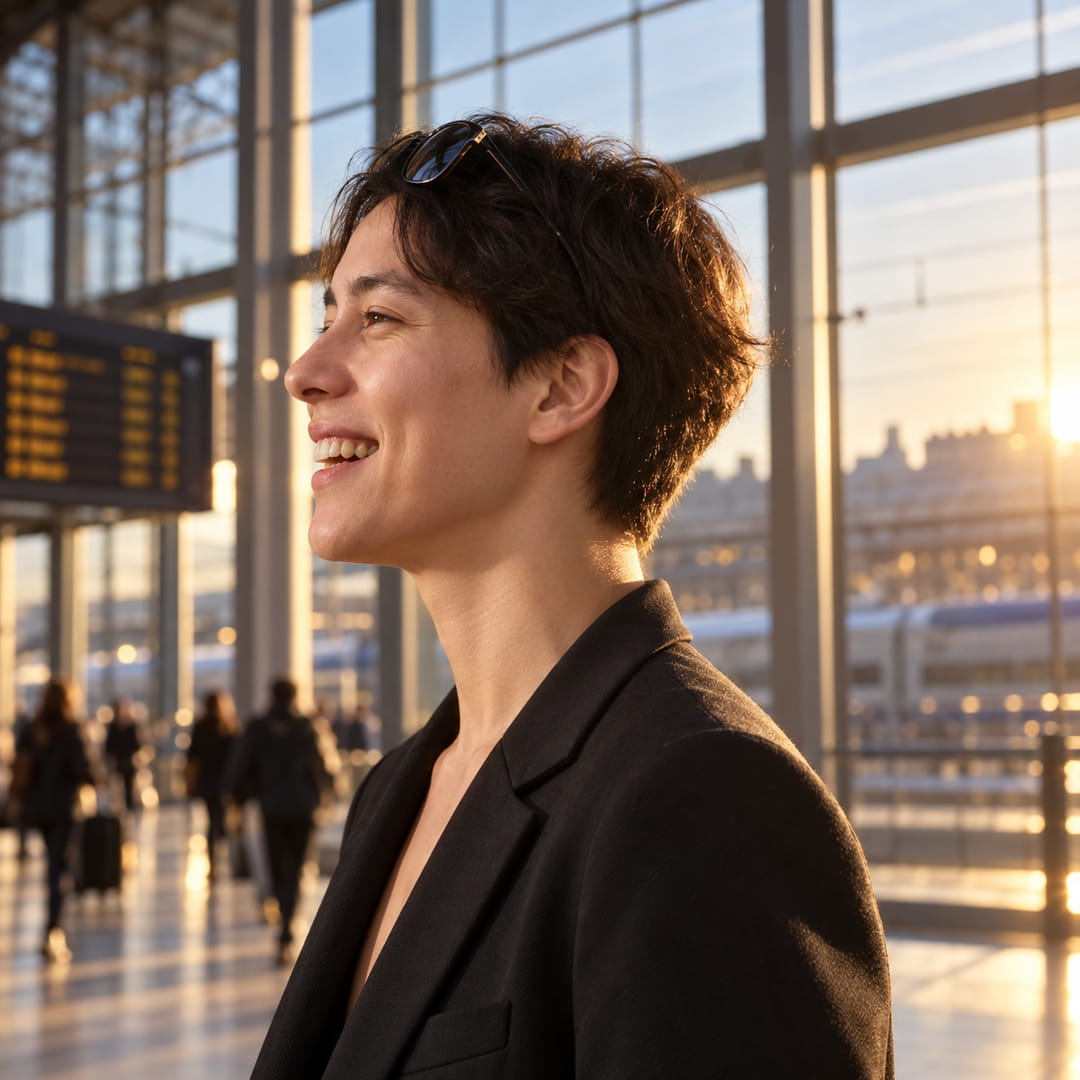
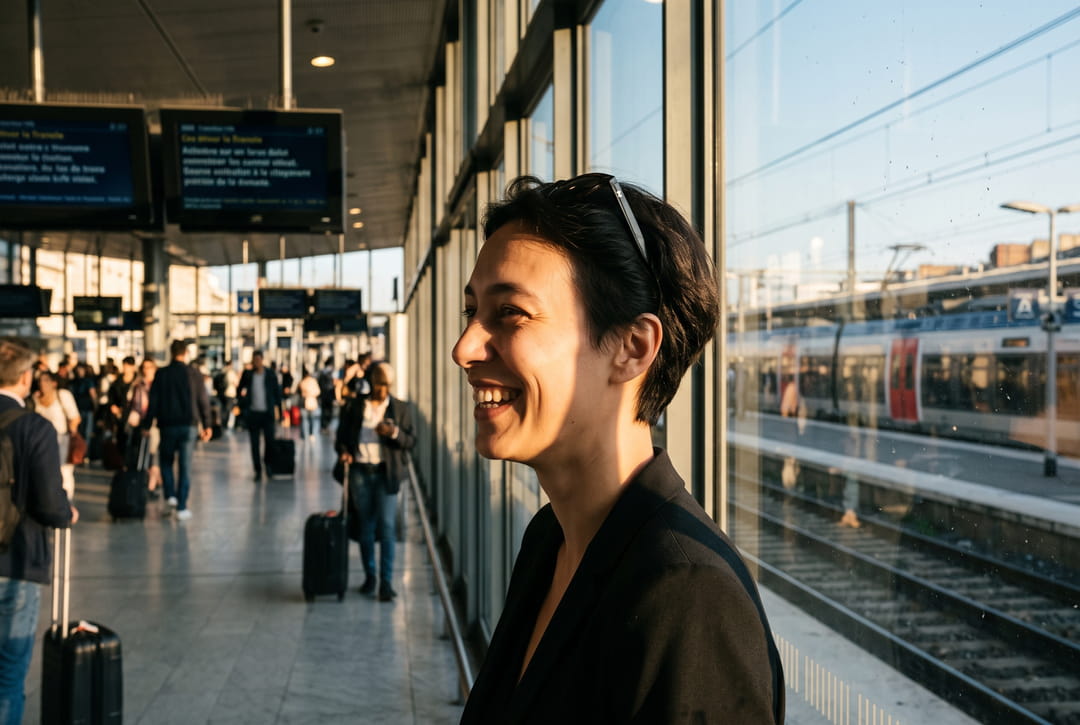
Gemini livre l’image la plus aboutie visuellement : une scène de gare dense, quais et voyageurs à l’arrière-plan, lumière rasante, ombres contrastées. Mais le visage n’est plus exactement celui de notre référence : des rides d’expression (peu crédibles) sont apparues. GPT-Image, à l’inverse, produit une scène plus générique et une lumière moins marquée, mais conserve l’identité.
4. Montage multi-références : Gemini l’emporte
Pour ce dernier test, nous évaluons les capacités de GPT et Gemini à générer une image cohérente comprenant plusieurs références visuelles. Nous donnons le portrait précédent et demandons au modèle de lui faire porter un imperméable jaune (image fournie), une tasse de café à la main (image fournie), dans un décor donné (image fournie).
Prompt :
Compose une seule image photoréaliste et cohérente à partir des quatre références : la même personne que l’image A, portant l’imperméable jaune vif à capuche de l’image B (doublure rayée marine et blanche, zip central, poches à rabat), avec le mug blanc de café au lait de l’image C, dans le décor de l’image D — rivage de galets au coucher du soleil, phare blanc, nuages roses, oiseaux au loin.
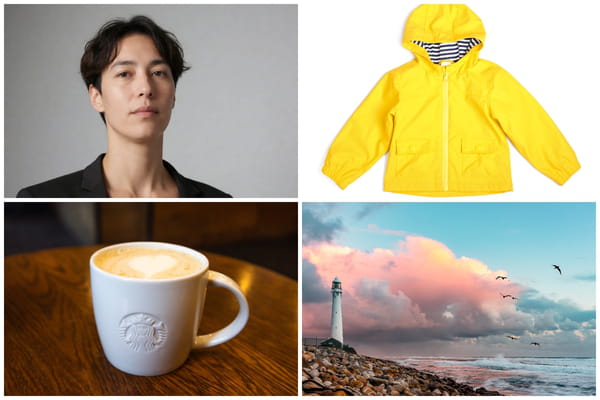
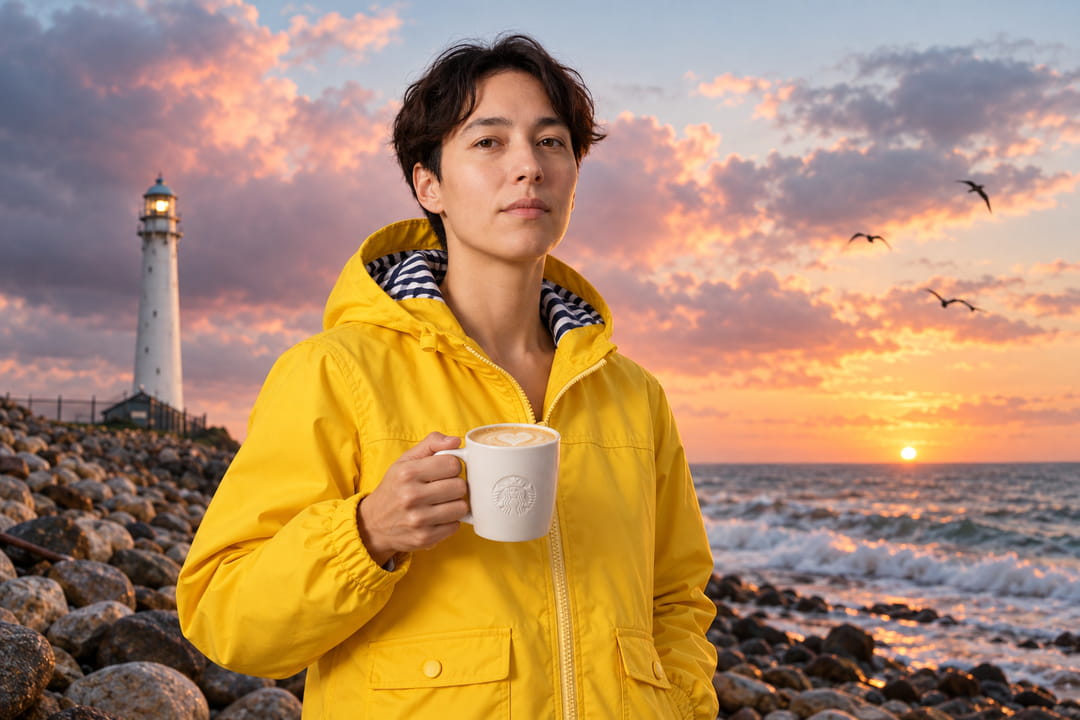
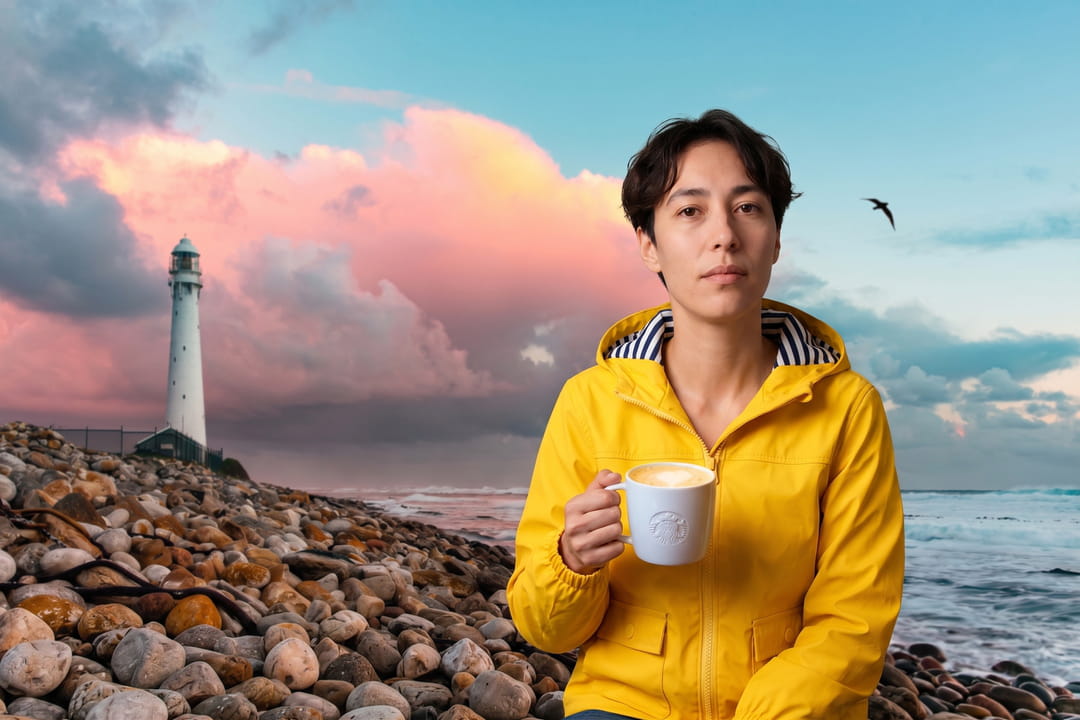
Le résultat est intéressant. Sur le papier, GPT propose la meilleure image : cadrage, disposition du visage, intégration du sujet dans la lumière. Mais il modifie complètement l’arrière-plan demandé. Il ne fait pas un photomontage, il semble plutôt tenter de reconstruire le paysage de référence. Gemini, lui, conserve la structure réelle. Les modèles d’image de Google sont réputés pour leur capacité à éditer une image sans réécrire des zones entières ; notre test le confirme.
GPT-Image génère, Nano Banana édite
Sur le photoréalisme et l’adhérence au prompt (suivi des instructions), GPT-Image 2.5 s’impose. Dès qu’il faut éditer une image, et surtout composer à partir de plusieurs références, Nano Banana 2 reprend la main : il conserve le décor là où le modèle d’OpenAI le reconstruit. Une équipe qui produit des assets visuels bruts ira donc chez OpenAI, une équipe qui retouche se rendra chez Google, en acceptant dans ce cas de payer l’image 6,8 cents contre 4,3. Les deux modèles sont accessibles par API, gpt-image-2.5-sunburst côté OpenAI, gemini-3.1-flash-image côté Google.