

On a mis Pangram sur le grill : que vaut le détecteur d'IA au cœur du buzz littéraire ?

La présence d’IA dans un texte peut-elle être détectée par de simples outils tiers ? C’est l’une des questions autour du battage médiatique du roman "C’était ça ou mourir" de Thélyson Orélien, accusé d’être partiellement voire totalement généré par l’IA. L’auteur des accusations, le compte "Balance ton Claude", s’est appuyé sur Pangram, une solution censée distinguer les textes générés par des modèles des textes humains. Le service revendique 0,0041% de faux positifs, soit un texte humain sur 24 000 classé à tort comme généré par IA. Qu’en est-il vraiment ? Nous avons soumis l’outil à plusieurs tests.
Comment fonctionne Pangram ?
Lancé en 2023 par Max Spero et Bradley Emi, deux anciens de Stanford, l’outil promet d’identifier les parties d’un texte générées à l’aide d’un LLM (grand modèle de langage). L’outil raisonne en probabilités, passage par passage, mais les résume en un verdict global assorti d’un niveau de confiance. L’objectif initial est de minimiser les faux positifs afin de pouvoir utiliser le système dans des contextes réels. Pangram repose sur un LLM de type MoE (mixture of experts, un modèle composé de plusieurs sous-réseaux spécialisés), entrainé sur des textes générés par plusieurs modèles d’IA et sur des textes de divers auteurs humains.
Côté chiffres, le taux de 0,0041% de faux positifs est mesuré sur plus d’un million de textes humains en anglais. En français, Pangram annonce 0,0026% de faux positifs, mais 1,78% de faux négatifs (des textes générés par IA qui passent pour humains).
Le modèle apprend, pendant son entrainement, à identifier les caractéristiques statistiques des textes générés par IA. Il analyse notamment la régularité des constructions, la distribution du vocabulaire, la structure des phrases ou encore la manière dont les idées s’enchaînent. Plus un texte testé est proche statistiquement d’un texte généré par l’IA pendant l’entrainement, plus le modèle aura tendance à lui attribuer l’étiquette de généré par IA.
Le test du JDN
Pour tester l’outil, nous lui avons soumis des textes entièrement rédigés par un humain, des textes générés par IA, puis des textes retouchés, à la main ou par une autre IA. Pour des questions de simplicité, nous avons utilisé l’API avec Pangram 4, la dernière version du modèle de l’entreprise, utilisé par défaut sur son site web.
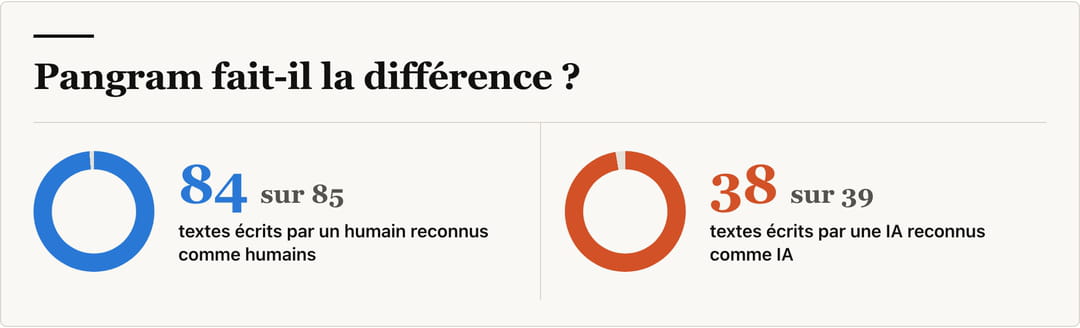
Commençons par les textes rédigés assurément par un humain. Nous avons fait analyser à Pangram pas moins de 85 textes, allant des résumés de thèses et d’articles scientifiques déposés avant 2020 à la Déclaration des droits de l’homme de 1789, en passant par des fiches pratiques, un article Wikipédia ou encore des articles du JDN. Sur les 85 textes envoyés, seul un faux positif remonte : une interview enregistrée du JDN transcrite avec Whisper, l’outil de transcription automatique d’OpenAI, puis retravaillée à la main. Pangram attribue pourtant 70% du texte à l’IA, avec un niveau de confiance élevé. Une erreur à la marge, mais qui mérite d'être signalée.
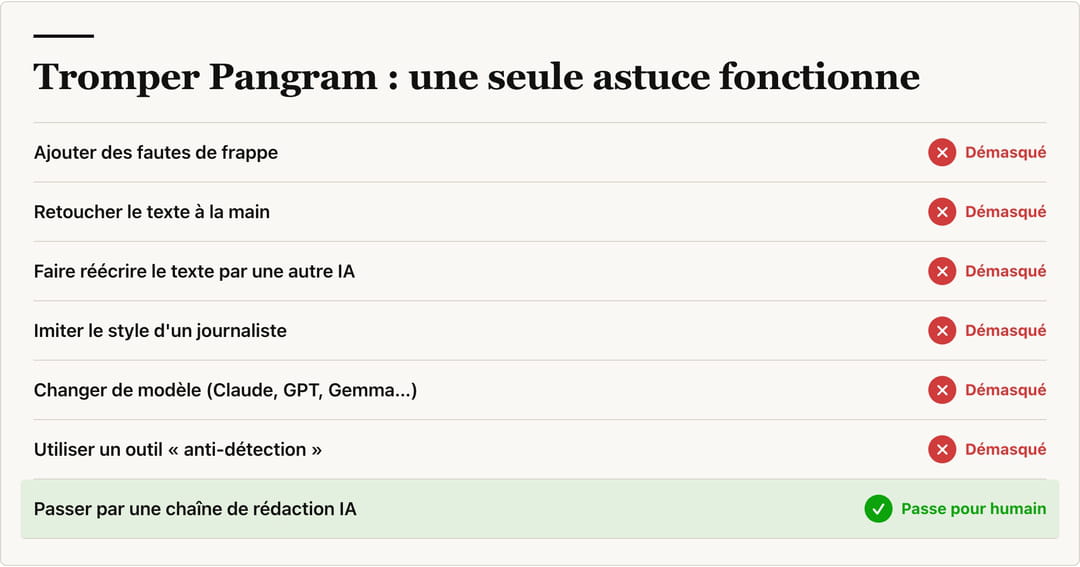
Plus intéressant, nous avons aussi tenté de voir si Pangram parvient à identifier réellement un texte généré par IA. Nous faisons rédiger à Claude Opus 5.5 et GPT-6 Astra (les derniers modèles d’Anthropic et d’OpenAI) un texte en demandant à l’IA de l’humaniser au maximum. L’IA identifie dans 100% des cas les textes générés par IA par une simple passe (on copie le texte sans aucune modification). Enfin, nous retouchons à la main un article d’actualité fictif entièrement généré par IA : le score de Pangram reste à 100%.
Toutefois, le score descend jusqu'à 84% s'il est réécrit par une seconde IA. Mais le verdict ne change pas : la totalité du texte reste attribuée à l’IA. Par ailleurs, ajouter simplement des fautes de frappe de manière aléatoire ne suffit pas à faire baisser le taux de détection, qui reste proche des 100%.
Mais allons plus loin et montons une rédaction virtuelle. Un premier modèle source les données, les fournit à un second agent qui rédige une première version de l’article. De là, un troisième agent, chargé du fact-checking, confronte l’article à la source, coupe les conclusions creuses et rajoute du contexte quand cela est nécessaire.
Bingo. A partir d’un véritable article, réécrit de bout en bout par l’IA, Pangram se laisse totalement berner. Que les agents tournent sur Claude Opus 5 ou sur GPT-4.1, le texte est détecté comme généré à 12%. Après une relecture et un fact-check, le score tombe à 0%. Selon nos différents tests, le texte rédigé par l'IA est beaucoup moins souvent détecté dès lors que le prompt initial est fourni avec des données sourcées. En somme, plus l’article est fidèle à la source, moins il est détectable.
Que faut-il en déduire ?
Pangram donne une idée très générale et assez générique pour savoir si un texte est généré avec de l’IA. Il va identifier les marqueurs d’un texte statistiquement plausible avec de l’IA. Le problème ? Il sert désormais à trancher sur un texte précis, un article ou un roman, avec une certitude qu’il ne peut pas offrir. Nous avons réussi à le tromper à plusieurs reprises. A l’inverse, un texte humain retouché par une IA reste classé humain. Nous avons fait reformuler cinq de nos articles par Claude Opus 5, jusqu’à changer deux tiers des mots : Pangram les attribue toujours à un humain. En revanche, quand l’IA écrit elle-même l’article à partir des mêmes informations, il la repère aussitôt. Il est toutefois impossible aujourd’hui d’affirmer qu’un texte a été produit par une IA ou un humain. L’outil permet seulement d’orienter et de donner des pistes, jamais de trancher. Et encore moins de dire si un texte a été simplement corrigé, reformulé ou entièrement généré par une IA.
Les techniques de watermarking invisible, déjà déployées sur Claude depuis cet été, permettront cependant de gagner en précision. Google et Anthropic orientent virtuellement Claude et Gemini vers un algorithme capable de générer statistiquement des tokens (mots ou parties de mots) définis. Un décodeur permet ensuite d’identifier statistiquement si un texte se rapproche de la signature de l’un ou de l’autre. Mais ni Google ni Anthropic n’ont encore mis à disposition un tel détecteur.
Outre la question purement technique, le sujet ouvre la voie à une question plus philosophique. Si le fond et la forme sont irréprochables, un texte généré par IA ne vaut-il pas un texte écrit par un humain ? La question reste ouverte. En attendant, GPT et Claude pourraient bien être les ghostwriters du 21e siècle.