
Code, finance, français, cybersécurité... On a testé Mistral Large 4

Le dernier-né de Mistral est un modèle d'IA surprenant. Avec seulement 3 800 GPU Nvidia Grace Blackwell, les équipes de la start-up parisienne sont parvenues à entraîner un modèle MoE de 1 000 milliards de paramètres. De son nom officiel Mistral Large 4 (ML4) ou de son surnom “le Chonk”, il est marketé par l’entreprise comme le meilleur modèle open weight (aux poids téléchargeables) hors de Chine. Il rivalise dans les benchmarks avec les modèles chinois récents sortis lors des derniers mois. Sur le papier, Mistral AI semble avoir “cracké” une partie du process de pré-entraînement et être revenu dans la course. Qu’en est-il vraiment ? Nous l’avons mis au défi.
Un modèle dans le haut des benchmarks
| Capacité évaluée | Mistral Large 4 (Preview) | GPT-6 Astra | DeepSeek-V4.1-Flash | GLM-5.3 | Kimi K3 | GPT-6 Luna | Benchmark |
|---|---|---|---|---|---|---|---|
| Intelligence | 38,4 | 52,7 | 39,5 | 44,8 | 43,6 | 38,1 | AA Intelligence Index v4.3.2 |
| Code en mode agentique | 61,7% | 74,1% | 74,2% | 69% | 69% | 66% | DeepSWE v1.1 |
| Code en terminal | 22,7% | 59,6% | 19,7% | 38,9% | 17,2% | 13,6% | Terminal-Bench 4.0 |
| Finance (analyste) | 54,68% | 53,54% | 53,48% | 55,84% | 53,11% | 49% | Finance Agent v2 |
| Juridique (agent) | 15,83% | 5,42% | 6,67% | 8,33% | 12,92% | 2,92% | Harvey’s Legal Agent Benchmark |
Le code ne sera pas le point fort de ML4, c’est une certitude. Si le modèle dispose de capacités “correctes” en code agentique (61,7% sur DeepSWE), il reste loin de DeepSeek V4 ou plus encore de GPT-6 Astra. Sur Terminal-Bench 4.0, référence sur la capacité de l’agent à utiliser un terminal, ML4 reste très en deçà des attentes avec un score de seulement 22,7% contre 38,9% pour GLM-5.3, sans compter les 59,6% de GPT-6 Astra. Le modèle de Mistral excelle toutefois dans l’analyse juridique, en cybersécurité et sur le grounding d’image satellite, et se défend bien en finance. Des capacités que Mistral markette davantage dans sa communication. Enfin, Mistral affirme également avoir travaillé en profondeur sur la qualité des données françaises du dataset pour l’entraînement. Le modèle serait donc plus capable en français que les autres modèles et éviterait notamment les tournures de style propres aux modèles anglophones.
| Modèle | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Mistral Large 4 (prix affiché) | 1,36 $ | 0,14 $ | 4,18 $ |
| GLM-5.3 (Z.ai) | 1,40 $ | 0,26 $ | 4,40 $ |
| GPT-6 Luna | 0,10 $ | 0,01 $ | 0,50 $ |
| GPT-6 Astra (OpenAI, tier standard) | 10 $ | 1 $ | 50 $ |
Côté pricing, Mistral reste dans le bas de la fourchette. L’entreprise, qui tire parti de l’ADN économe de son modèle, propose des prix en mode API largement sous le marché. Au prix plein, ML4 s’aligne sur GLM-5.3 et coûte environ 12 fois moins cher que GPT-6 Astra en sortie. Mais Mistral accorde 50% de remise pendant les 15 premiers jours du lancement, qui font tomber les prix à 0,68 dollar en entrée, 0,07 en cache et 2,09 dollars en sortie : deux fois moins que GLM-5.3 et 24 fois moins que GPT-6 Astra. Les coûts mesurés dans nos tests correspondent à ce tarif remisé. En revanche, dès que l’on compare à GPT-6 Luna, le modèle reste beaucoup plus cher. Il est toutefois légèrement meilleur de façon générale sur les benchmarks.
Le test du JDN
Pour tester les capacités réelles de Mistral, nous allons lui soumettre quatre tests différents. Nous comparons donc Mistral Large 4 à ses concurrents de premier plan : GPT-6 Luna et GLM-5.3. Nous avons interrogé les modèles depuis l’endpoint d’OpenRouter en mode de raisonnement high pour chaque modèle. Le premier test (afin de l’évacuer rapidement) : la création d’un SVG animé pour tester ses capacités brutes en code ; le second : rédiger un texte en français irréprochable sans source de données ; le troisième : analyser un document financier complexe ; et enfin le dernier : lui faire auditer un morceau de code dans lequel nous avons glissé des failles de sécurité.
SVG animé : GLM-5.3 en tête
Pour ce premier test, nous allons demander au modèle de produire un SVG animé d’une fusée qui décolle. Le but ? Analyser la génération de code en un seul bloc, la maîtrise des éléments visuels, le raisonnement spatial et enfin la connaissance pure du SVG et du CSS.
Nous donnons le prompt suivant aux modèles :
Crée un fichier SVG animé autonome (sans JavaScript, animations SVG ou CSS uniquement) représentant une fusée qui décolle.

La scène doit comporter :
- un ciel de nuit avec des étoiles qui scintillent ;
- un pas de tir au sol ;
- une fusée détaillée (corps, hublot, ailerons) ;
- des flammes animées sous la fusée et un nuage de fumée au décollage ;
- une animation de 5 secondes en boucle : allumage, décollage, sortie par le haut de l'image.
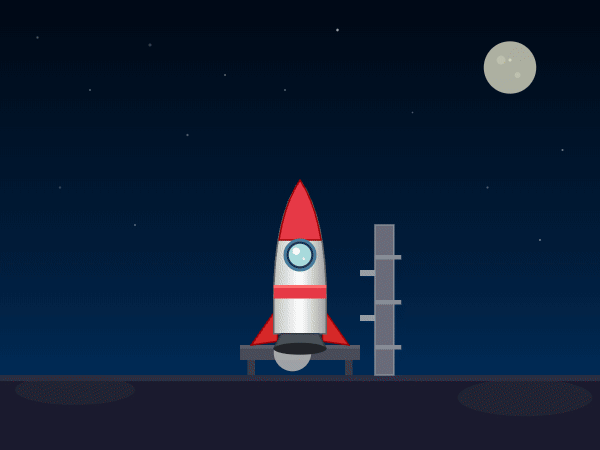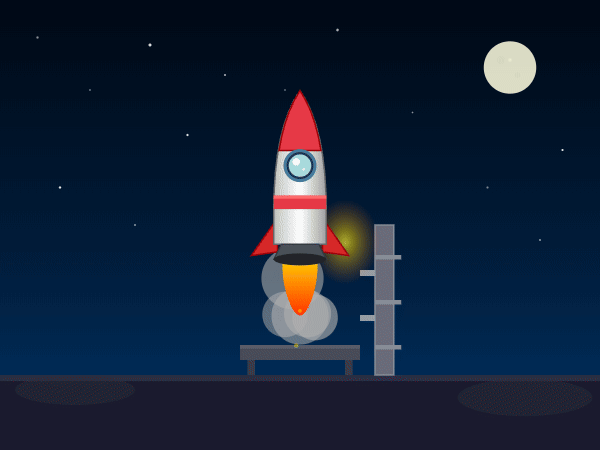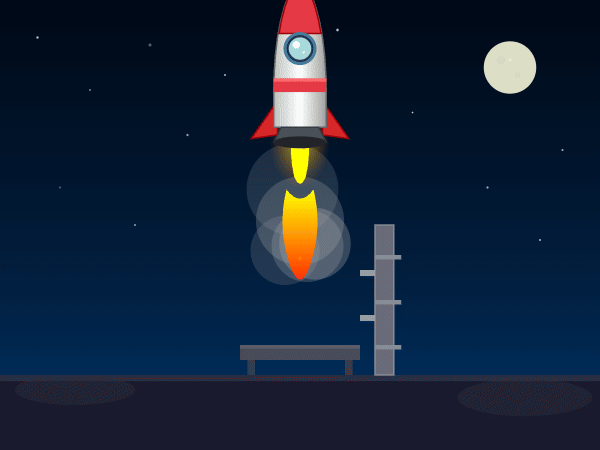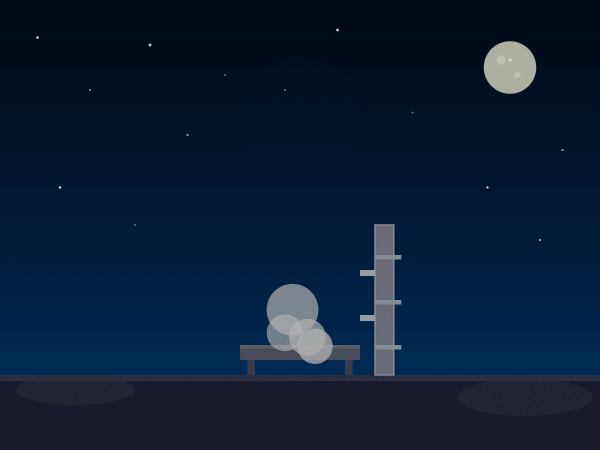
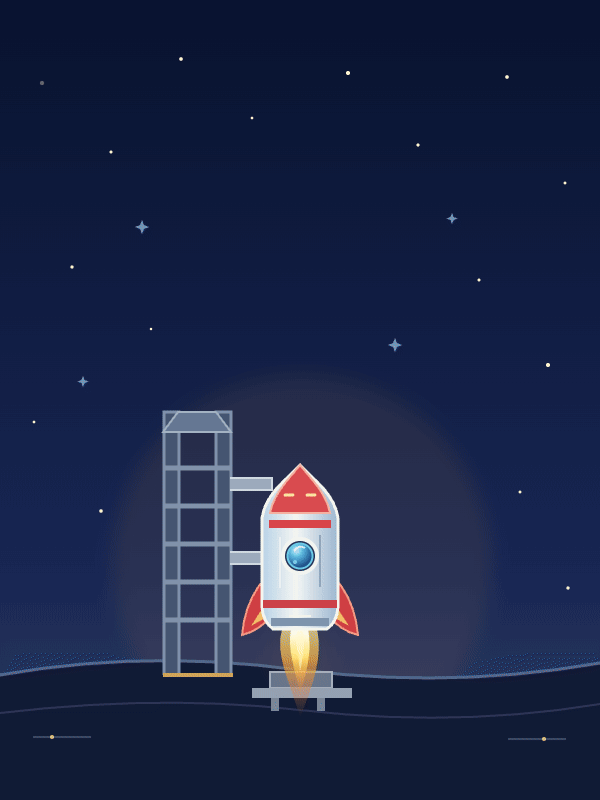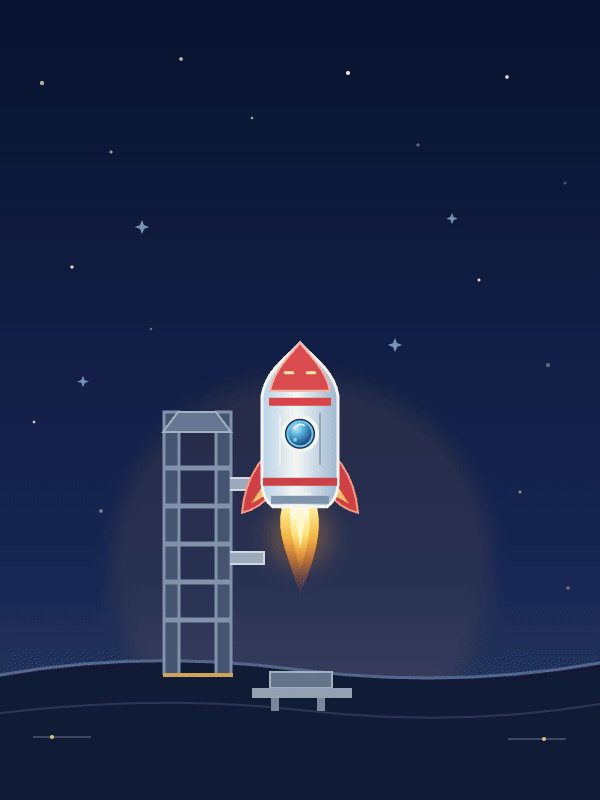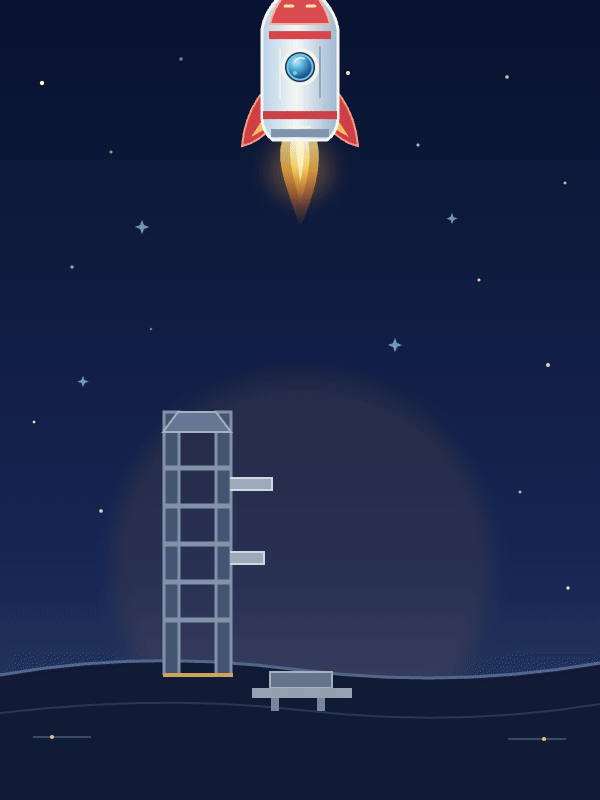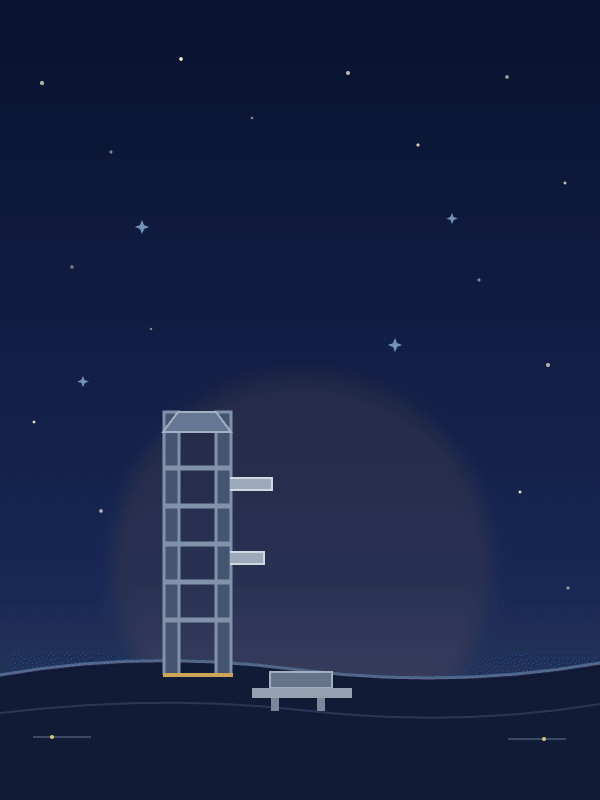
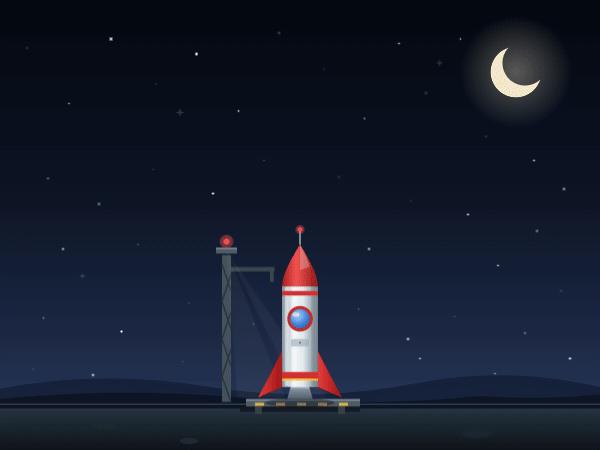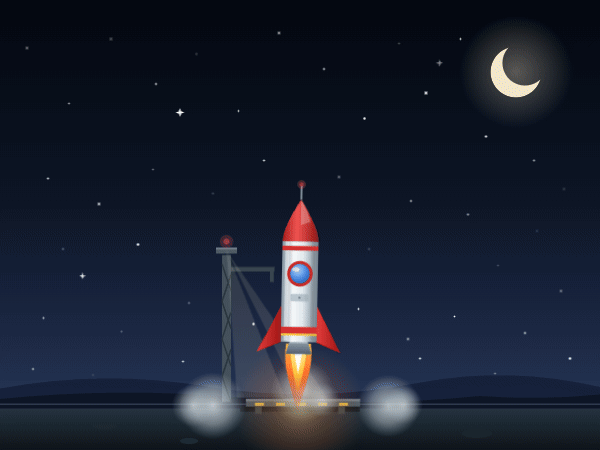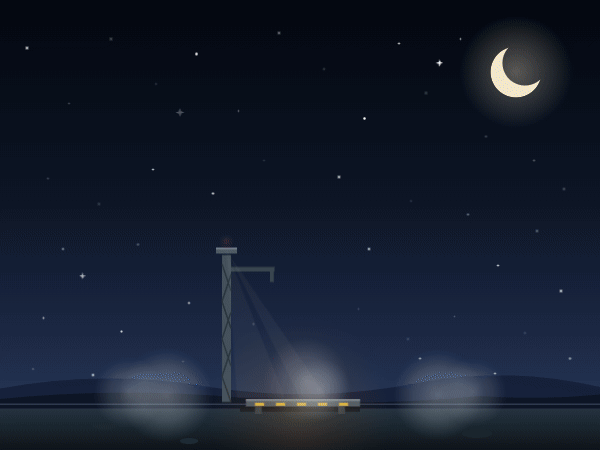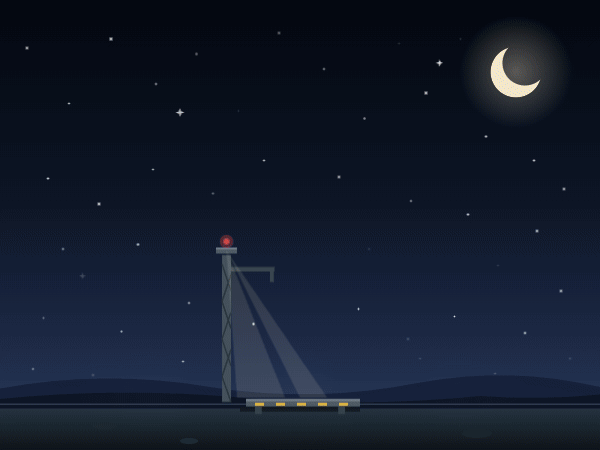
Mistral propose une animation de fusée crédible mais, malheureusement, plusieurs artefacts, notamment autour de l’animation des flammes, sont visibles. Cela ressemble très fortement à un bug de calage du CSS. C’est dommage. Enfin, côté graphique, le décor est minimal. GLM-5.3, de son côté, livre la version la plus aboutie, plus proche des modèles frontières. Luna reste moyen, visuellement peu attrayant, mais le mouvement est tout à fait correct.
| Mistral Large 4 | GPT-6 Luna | GLM-5.3 | |
|---|---|---|---|
| Vitesse | 48 tok/s | 115 tok/s | 105 tok/s |
| Tokens entrée | 198 | 208 | 224 |
| Tokens sortie | 10 436 | 5 654 | 30 903 |
| dont réflexion | 5 309 (51%) | 2 215 (39%) | 22 995 (74%) |
| Prix total | 0,0219 $ | 0,0028 $ | 0,0681 $ |
Très logiquement, Luna reste le modèle le plus rapide et le moins cher. GLM-5.3 est trois fois plus cher que Mistral, notamment car il raisonne beaucoup plus longtemps que ML4. GLM-5.3 remporte toutefois ce test sur le résultat final.
Rédaction : Mistral séduit sur la forme
Nous demandons ici au modèle de générer un éditorial en français sur un sujet donné (aucun modèle n’a accès au web). La demande est précise et exige un registre soutenu, nuancé, et au moins une phrase au subjonctif et une concordance des temps au passé.
Prompt :
Rédige un éditorial de 400 mots pour un magazine économique français sur ce sujet : « Les réunions de travail sont-elles devenues inutiles ? »

Contraintes :
- registre soutenu, ton argumenté et nuancé ;
- au moins une phrase au subjonctif et une concordance des temps au passé ;
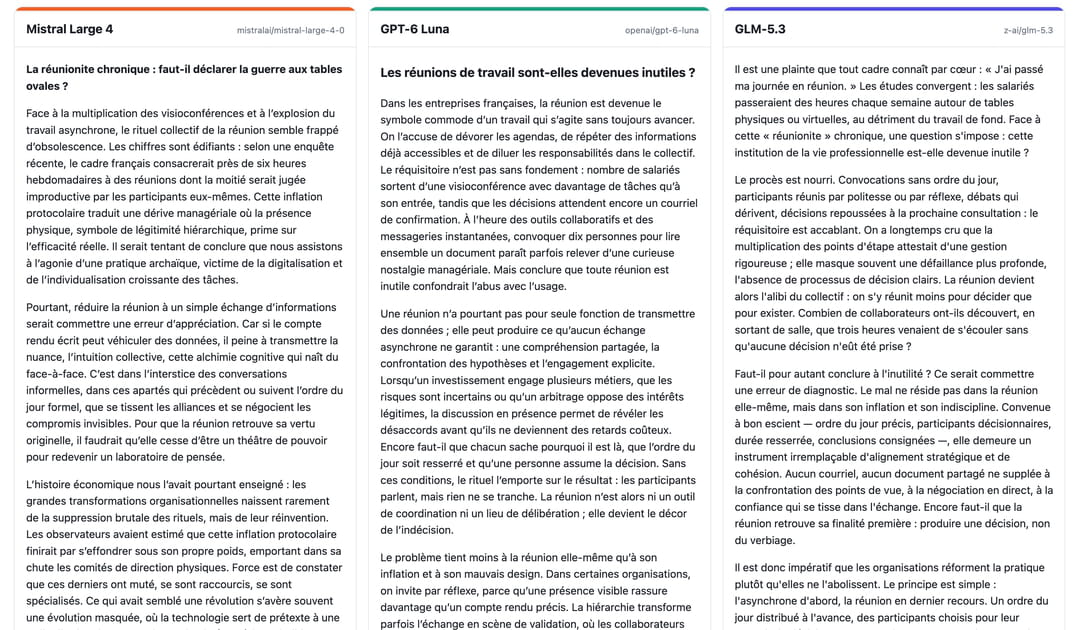
Sur la forme uniquement, Mistral gagne grâce à un texte assez agréable à lire malgré de nombreuses tournures pompeuses. Il a souvent le style le plus percutant. En revanche, sur le fond, Mistral produit le texte le moins argumenté : il aurait fallu lui apporter plus de données. Les trois modèles respectent la consigne initiale de subjonctif et de concordance des temps au passé. GPT-6 Luna propose le meilleur compromis forme / fond.
| Mistral Large 4 | GPT-6 Luna | GLM-5.3 | |
|---|---|---|---|
| Vitesse | 13 tok/s | 46 tok/s | 103 tok/s |
| Tokens entrée | 70 | 72 | 86 |
| Tokens sortie | 1 893 | 3 354 | 8 517 |
| dont réflexion | 1 518 (80%) | 2 758 (82%) | 7 378 (87%) |
| Prix total | 0,0040 $ | 0,0017 $ | 0,0376 $ |
Sur le prix, GPT-6 Luna gagne encore haut la main. GLM-5.3 coûte de son côté 22 fois plus que Luna pour un résultat beaucoup moins bon. Mistral revient un peu plus cher (2,4 fois plus) mais reste tout à fait crédible. Un fond décevant pour l’exercice présenté comme le point fort de Mistral.
Analyse financière : GLM-5.3 vraiment tranchant
Nous évaluons ici la capacité de ML4 à analyser un document long, complexe et qui plus est financier. C’est censé être l’autre gros point fort de Mistral. Nous donnons donc le document d’introduction en Bourse de SpaceX et demandons à l’IA de répondre à plusieurs questions précises : certaines imposent d’aller chercher l’information factuelle, d’autres sont des questions d’analyse où le modèle doit mobiliser ses capacités financières pour répondre.
Prompt :
Voici le document d'introduction en Bourse de SpaceX. Analyse-le en deux temps.

Partie 1 – Faits (cite à chaque fois la section ou la page d'où vient l'information) :
Quel est le chiffre d'affaires du dernier exercice et son évolution sur un an ?
L'entreprise est-elle rentable ? Donne le résultat net.
Quels sont les trois principaux facteurs de risque mis en avant ?

Partie 2 – Analyse (prends position et justifie avec des éléments chiffrés du document) :
Le modèle économique te paraît-il soutenable ? Pourquoi ?
Quel est, selon toi, le risque le plus sous-estimé ou le moins mis en avant dans le document ?
Pour un investisseur, quels sont les deux arguments les plus forts pour investir et les deux plus forts pour s'abstenir ?

Répond sous forme de liste à puce brève.
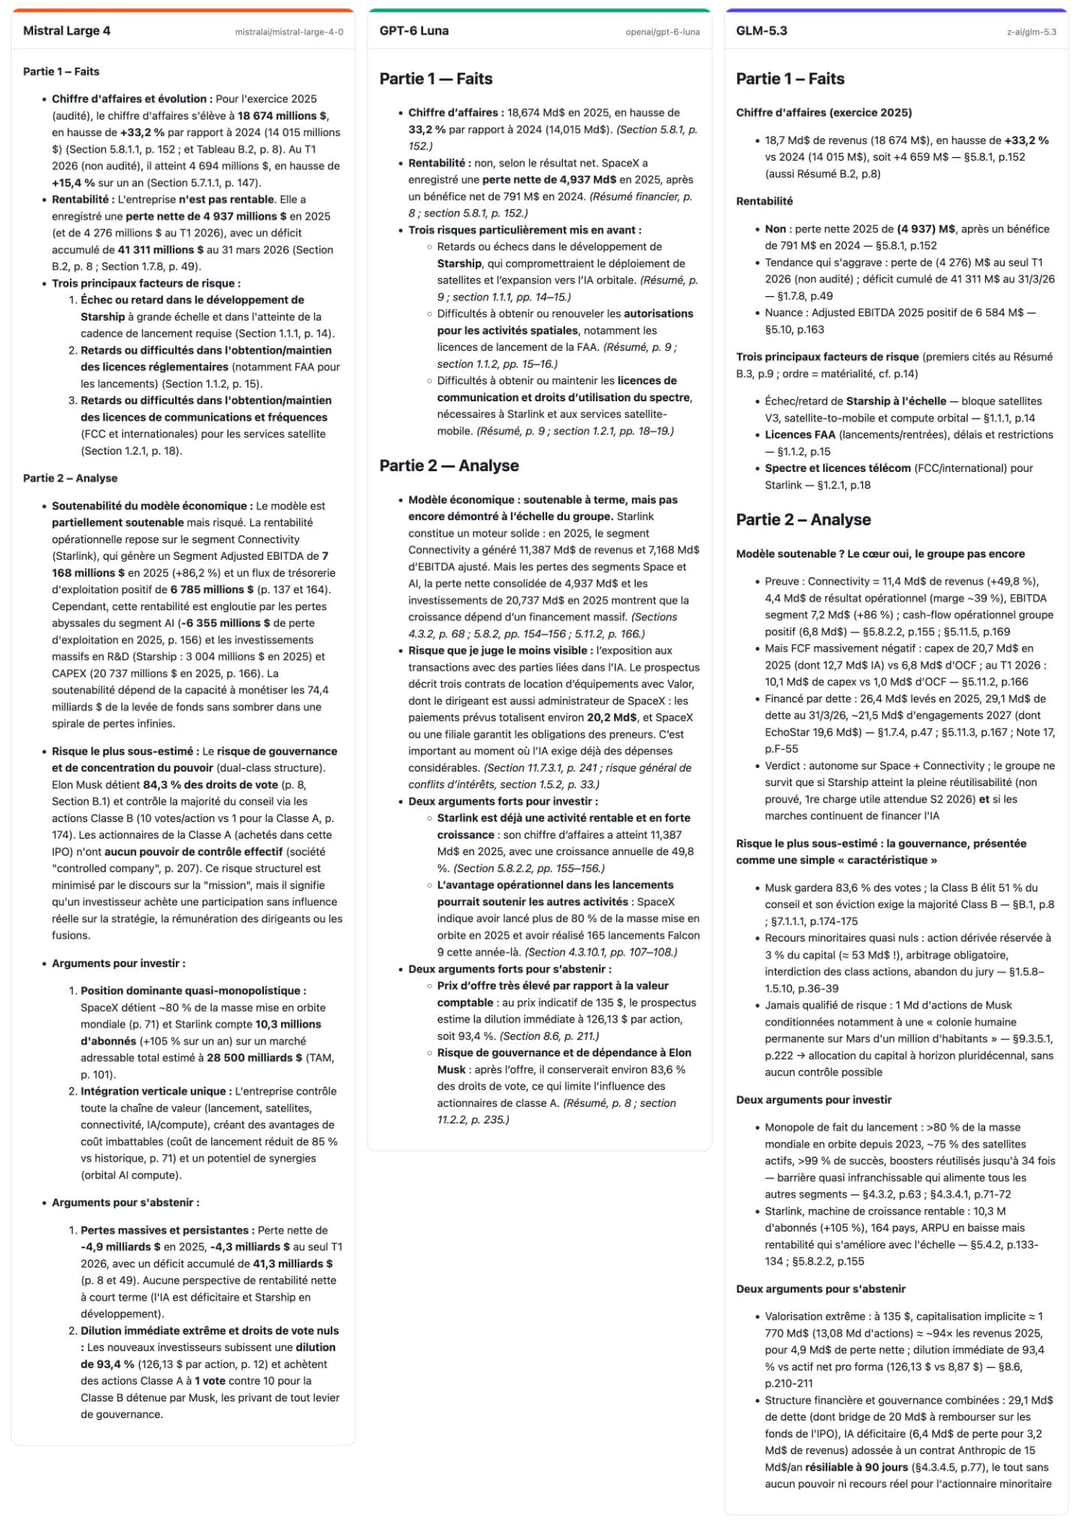
Sur la recherche des faits, Mistral Large 4 est juste et factuel, et source chacune de ses informations, tout comme GPT-6 Luna. Les deux modèles retrouvent sans erreur le chiffre d’affaires 2025, la perte nette et les trois risques placés en tête du document. GLM-5.3 va un peu plus loin en apportant de la nuance et des informations complémentaires. Les trois modèles sont donc à égalité sur les faits.
Sur l’analyse, en revanche, les écarts se creusent. Mistral Large 4 reste très (trop) factuel et évite de trancher : il juge le modèle économique “partiellement soutenable” et reprend sans recul le marché potentiel de 28 500 milliards de dollars avancé par le document. GPT-6 Luna se montre plus tranchant. Il déniche un risque peu visible : des contrats de location de matériel informatique conclus avec Valor. GLM-5.3 livre l’analyse la plus aboutie. Il tranche clairement.
| Mistral Large 4 | GPT-6 Luna | GLM-5.3 | |
|---|---|---|---|
| Vitesse | 12 tok/s | 88 tok/s | 62 tok/s |
| Tokens entrée | 380 455 | 374 662 | 385 107 |
| Tokens sortie | 2 318 | 2 442 | 11 649 |
| dont réflexion | 1 119 (48%) | 1 536 (63%) | 8 222 (71%) |
| Prix total | 0,2636 $ | 0,0955 $ | 0,5904 $ |
Sur le prix, Luna est encore le gagnant, avec une réponse équilibrée pour un coût modique. GLM-5.3 semble gagner en précision et en nuance grâce à son raisonnement plus long que celui des deux autres modèles.
Audit de sécurité : Mistral le plus complet
Nous soumettons à ML4 et aux deux autres modèles le code d’une petite API de facturation. Nous avons glissé huit failles de sécurité plus ou moins subtiles (injection SQL, accès aux factures d’autres clients, réinitialisation de mot de passe contournable…). Nous mesurerons quel modèle arrivera à remonter le plus de failles, sans faux positif.
Prompt :
Un développeur de l'équipe propose ce fichier dans une pull request. Il s'agit de l'API d'une application de facturation qui sera mise en production la semaine prochaine. Fais la revue de ce code. Dis-moi si on peut le fusionner en l'état, et sinon, liste les problèmes par ordre de gravité, avec pour chacun : la ligne concernée, le risque concret et le correctif proposé. Répond sous forme de tableau stp.
| Failles critiques (/8) | Failles secondaires | Failles inventées | |
|---|---|---|---|
| Mistral Large 4 | 8/8 | 6 | 0 |
| GPT-6 Luna | 8/8 | 3 | 0 |
| GLM-5.3 | 8/8 | 5 | 0 |
Sur l’analyse du code source, les trois modèles arrivent à identifier nos huit failles de sécurité (clé en dur, mode debug activé, injection SQL…). En revanche, Mistral parvient à trouver le plus de failles secondaires (6/7). Aucun modèle n’a inventé de faille.
| Mistral Large 4 | GPT-6 Luna | GLM-5.3 | |
|---|---|---|---|
| Vitesse | 35 tok/s | 46 tok/s | 129 tok/s |
| Tokens entrée | 1 124 | 1 112 | 1 135 |
| Tokens sortie | 5 192 | 4 553 | 13 703 |
| dont réflexion | 3 480 (67%) | 3 331 (73%) | 11 978 (87%) |
| Prix total | 0,0116 $ | 0,0024 $ | 0,0619 $ |
Côté prix, GLM-5.3 reste le plus cher, devant Mistral et GPT-6 Luna. Le modèle de Z.ai raisonne toujours davantage, sans obtenir pour autant de meilleurs résultats ici. Mistral, lui, raisonne relativement peu au vu des failles trouvées, c’est notable.
Un modèle souverain encore en retrait
Avec Mistral Large 4, la start-up propose un modèle capable, a minima, d’être comparé aux solutions chinoises open source. S'il n’arrive pas à la cheville des modèles américains, il reste une bonne solution pour l’entreprise qui souhaite utiliser une couche d’IA générative entièrement souveraine, du modèle à l’inférence.
Face aux modèles de taille comparable, Mistral Large 4 reste également un cran en dessous. Ses capacités en code sont limitées et son analyse financière, solide sur les faits, a manqué de recul dans notre test. Ses vrais points forts restent la maîtrise plus fine du style français et la rigueur de son audit cyber. Pour des capacités réellement intelligentes, il est encore assez moyen. Mais avec les releases à venir dans les prochaines semaines, et avec une stack hardware d’entraînement appelée à croître, les résultats ne pourront être que meilleurs. Et il ne faut pas oublier la prouesse originelle : la start-up française a créé son modèle avec seulement 3 800 GPU Nvidia, contre plusieurs centaines de milliers (a minima) chez les concurrents chinois et américains.