
Fable 5.2 & Mythos 5.2 : le coup d'éclat d'Anthropic juste avant son IPO

Anthropic montre les muscles avant son introduction en Bourse (IPO). L’éditeur de Claude a dévoilé lundi 9 novembre la nouvelle version de son modèle le plus puissant, déclinée en deux variantes : Claude Fable 5.2 et Claude Mythos 5.2. La première, destinée au grand public, démontre des capacités grandement améliorées en code, raisonnement, vision et vitesse. La seconde (Mythos) offre des capacités cyber améliorées pour les organisations triées sur le volet, via des programmes de vérification en cybersécurité et en sciences du vivant. Plus intéressant encore, les deux modèles gagnent de nouvelles capacités, notamment en recherche scientifique et en robotique. Le prix, lui, affiche une légère baisse.
Le meilleur modèle universel au monde ?
| Capacité testée | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon | Benchmark |
|---|---|---|---|---|---|
| Code agentique | 49,1% | 45,5% | 42,8% | 41,1% | FrontierCode 2.0 |
| Résolution de bugs | 69,9% | 62,3% | 65,5% | 61,2% | FrontierSWE v2 |
| Automatisation de workflows métier | 51,4% | 42,5% | 41,4% | 53,9% | AutomationBench |
| Recherche scientifique autonome | 74,6% | 58,7% | 68,1% | 64,8% | Terminal-Bench-Science 0.1 |
| Cybersécurité (score de Mythos 5.2) | 76,3% | 67,6% | 61,0% | NC | CyScenarioBench |
| Recherche web | 82,1% | 72,3% | NC | NC | WANDR (relaxed score) |
| Computer use | 89,3% | 87,2% | 79,5% | 81,5% | OSWorld 2.1 (offline set, partial) |
| Robotique | 64,9% | 39,4% | 29,8% | NC | RoboDojo Sim |
| Raisonnement multidisciplinaire | 74,2% | 67,7% | 57,2% | NC | Humanity’s Last Exam (avec outils) |
| Vision | 73,4% | 64,4% | 71,0% | 72,5% | Chartography (sans outils) |
Fable 5.2 et Mythos 5.2 ne sont en fait qu’un seul et même modèle. La principale différence réside dans les garde-fous appliqués à leurs sorties. Mythos est capable de mener des tâches de cybersécurité et de biologie avancée quand Fable 5.2 appliquera des garde-fous stricts et refusera souvent de répondre. Anthropic communique donc surtout sur les benchmarks de Fable 5.2, modèle qui sera le plus massivement diffusé auprès du grand public.
Avec ce modèle (version bridée et version non bridée), Anthropic va au-delà d’un simple modèle frontière pour le code. L’entreprise le positionne comme un modèle universel adapté à toutes les tâches complexes. Il excelle d’abord en code agentique avec des scores bien supérieurs à Claude Opus 5.5, déjà référent sur les benchmarks (49,1% contre 45,5%). Il talonne Gemini 4 Carbon sur l’automatisation des tâches métiers (51,4% contre 53,9%) et brille en cybersécurité offensive comme défensive (Mythos donc, pas FAble). En vision (analyse de graphiques) et en computer use, il se positionne également comme le meilleur modèle, avec une légère avance. En recherche web, l’écart est net : 82,1% contre 72,3% pour Opus 5.5. Bref : c’est un modèle taillé pour réaliser n’importe quelle tâche, quelle que soit sa nature.
La vraie nouveauté, au-delà de ses très bons scores dans les benchmarks de code et de raisonnement, reste la recherche scientifique et la robotique. Le modèle marque un vrai gap en simulation robotique avec un score de 64,9% contre 39,4% pour Opus 5.5 et seulement 29,8% pour GPT-6 Astra. Il se distingue également en recherche scientifique autonome (74,6% contre 68,1% pour GPT-6 Astra). Fable 5.2 est parvenu à résoudre en autonomie deux questions de physique encore ouvertes sur les trous noirs. Mythos 5.2 a de son côté orchestré deux modèles open source pour prédire la structure des capsides AAV (l’enveloppe de virus utilisés en thérapie génique), avec 28 réussites sur 34. Une équipe de 1 000 agents Fable 5.2 a aussi vérifié par ordinateur la preuve du théorème de Fermat en 30 heures, quand Opus 5.5 n’en avait bouclé que 26% en 18 heures. Enfin, en robotique, Anthropic affirme que son modèle est capable de généraliser à certaines situations non apprises pendant l’entraînement. Une capacité qui commence à faire douter certains chercheurs de la pertinence à long terme des world models.
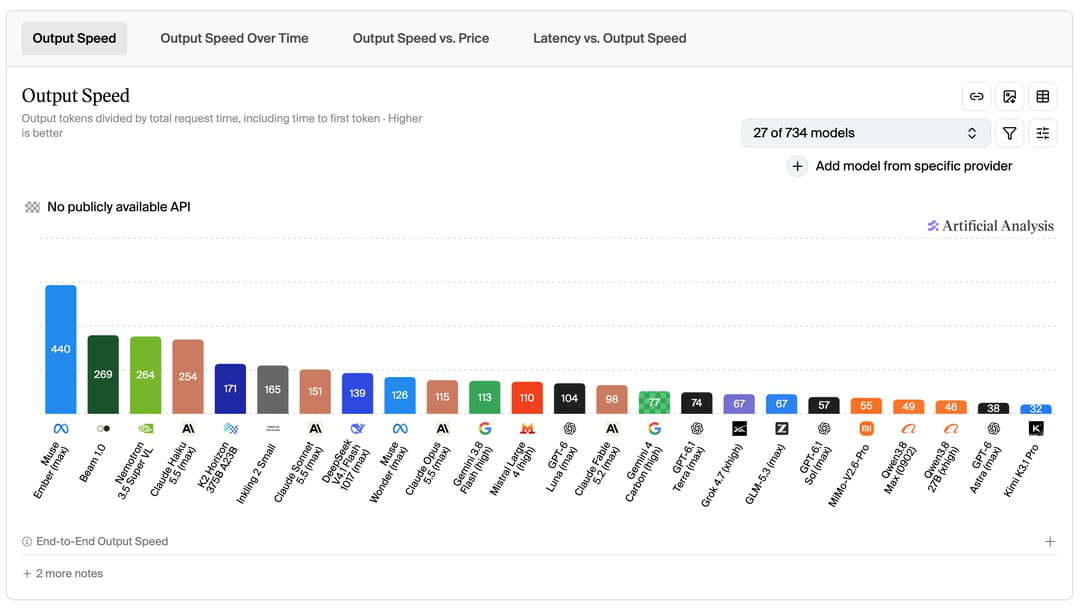
Dernier point, et c’est une métrique qui compte, le modèle est jusqu’à 30% plus rapide que Fable 5.1. Artificial Analysis mesure environ 98 tokens par seconde en raisonnement max, soit au-dessus de Gemini 4 Carbon (77 tokens par seconde). Le modèle est également plus efficace, ce qui lui permet de gagner du temps sur une tâche donnée.
Un prix en baisse… sur le papier
| Modèle | Input ($/M tokens) | Output ($/M tokens) | Cache (lecture) ($/M tokens) | Mode fast input ($/M tokens) | Mode fast output |
|---|---|---|---|---|---|
| Claude Fable 5.2 | 8,00 $ | 40,00 $ | 0,20 $ | 16,00 $ | 80,00 $ |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ | 8,00 $ | 40,00 $ |
| GPT-6 Astra | 10,00 $ | 50,00 $ | 1,00 $ | 20,00 $ | 100,00 $ |
| Gemini 4 Carbon | 4,00 $ | 20,00 $ | 0,10 $ | NC | NC |
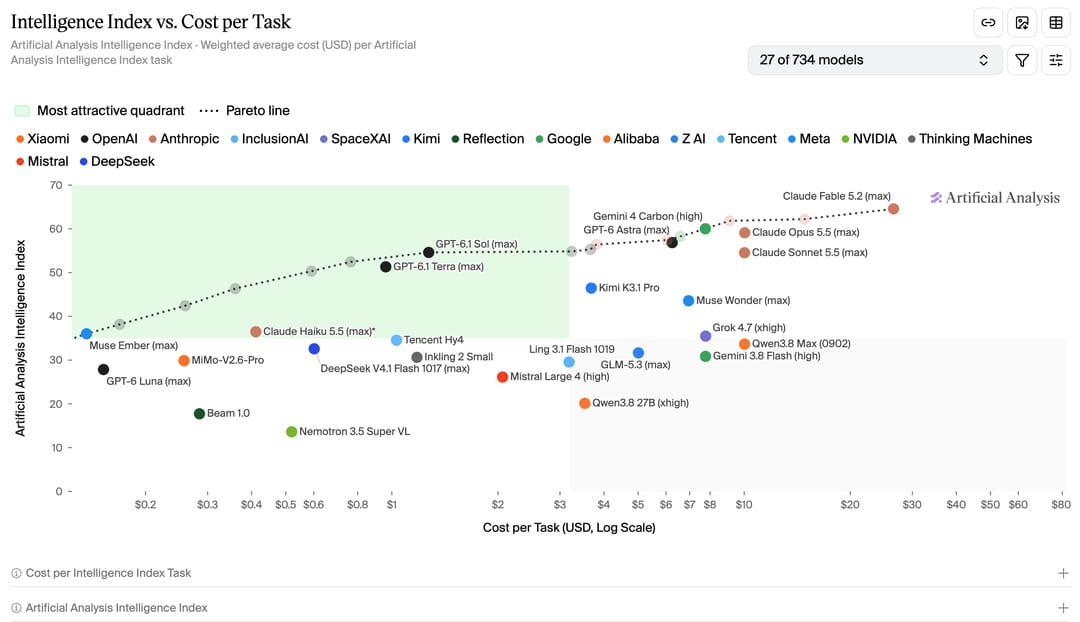
Anthropic annonce une baisse de prix de l’ordre de 20% autant en input qu’en output par rapport à Claude Fable 5.1 (10 et 50 dollars par million de tokens). Pour autant, le modèle coûte systématiquement plus cher sur les tâches testées, selon les mesures d’Artificial Analysis. Résultat, même si GPT-6 Astra est plus cher sur le papier, il est moins cher dans la réalité : environ 6 dollars par tâche de l’indice d’Artificial Analysis, contre une dizaine pour Opus 5.5 et près de 27 pour Fable 5.2. Claude Fable 5.2 est donc à utiliser uniquement pour les tâches complexes sur lesquelles Opus 5.5 et les autres modèles frontières échouent. Sur les tâches classiques de code, il videra plus vite votre forfait, ou coûtera plus cher via l’API. Par ailleurs, Fable 5.2 peut consommer jusqu’à 50% des limites d’usage hebdomadaires sur les abonnements Pro et Team standard.
Un modèle pensé pour l’IPO ?
Avec Fable 5.2 et Mythos 5.2, Anthropic joue sur deux tableaux. Le premier, celui de ses clients historiques, qui disposent désormais d’un modèle de pointe pour répondre aux cas d’usage les plus complexes : orchestration de dizaines d’agents, recherche autonome, R&D, cyber. Le second : avec l’arrivée des capacités de recherche scientifique autonome, de biologie avancée et surtout de la robotique, Anthropic cible désormais de nouvelles industries. L’objectif, à lire entre les lignes, est clair : diversifier son panel de clients pour stimuler ses revenus récurrents grâce à des industries porteuses. A la clef, des perspectives de croissance des revenus et un élargissement de sa base de clients qui pourraient séduire encore un peu plus les éventuels acquéreurs de la future action ANT.