

Le GEO n'est pas un nouveau métier, c'est une nouvelle expertise

On entend depuis deux ans qu'un bon SEO suffit pour être visible dans les réponses IA. C'est vrai sur une large part du chemin, mais plus à une étape précise, qui exige d'autres leviers.
SEO ou GEO : un faux débat
Google le dit depuis deux ans et l'a écrit noir sur blanc le 15 mai dernier, dans une documentation intitulée « Optimizing your website for generative AI features on Google Search » : Google présente l’optimisation pour ses fonctionnalités génératives comme une continuité de l’optimisation pour l’expérience de recherche, donc comme une extension du SEO. Une partie du marché défend au contraire l’idée que le GEO constituerait une discipline entièrement nouvelle. De mon point de vue, le GEO n'est pas un nouveau métier : les fondamentaux SEO restent indispensables, mais certains leviers propres aux environnements génératifs justifient une expertise complémentaire.
L'argumentaire le plus solide en faveur de la position de Google a été publié début août par Cyrus Shepard, consultant SEO américain de référence (Zyppy, ex-Moz) : pour l'immense majorité des sites, on atteint plus de 90% de ses objectifs de visibilité IA en réorientant des leviers SEO existants (son analyse est ici). J'y souscris, et je crois qu'il faut le dire fort en France, où l'on survend volontiers la rupture entre SEO et GEO (ou AEO).
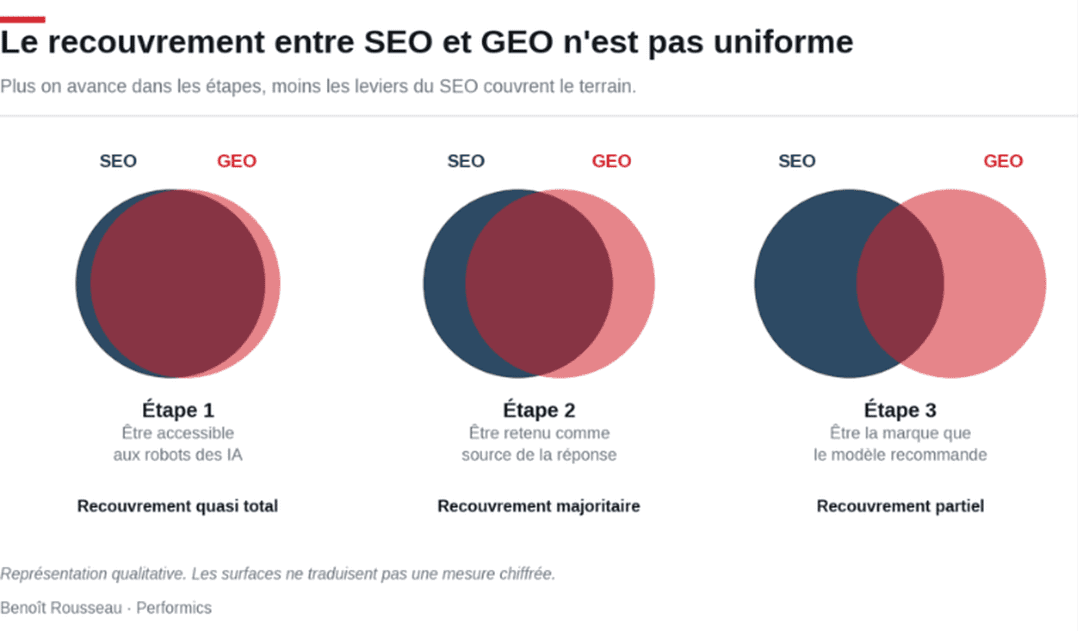
Il existe cependant une nuance que l'activation d'AI Overviews et d'AI Mode en France, le 22 juillet dernier, rend enfin observable. Ces 90% ne sont pas répartis uniformément. Le pourcentage varie selon le type de moteur interrogé et selon ce que l'on cherche à obtenir : être lu, être cité, ou être recommandé.
Il n'y a pas une IA, il y a quatre surfaces
L'erreur la plus fréquente, y compris dans les briefs que nous recevons, consiste à parler de visibilité IA au singulier. Quatre surfaces coexistent et ne consomment pas la même matière première. Par surface, j'entends un endroit distinct où une IA formule sa réponse : un encart dans une page de résultats, un assistant conversationnel, un moteur de réponse.
- AI Overviews. L'entrée se fait par une requête de recherche, et non une phrase conversationnelle. Le point est capital pour la mesure : un corpus rédigé en prompts ne se mesure pas dans AI Overviews. C'est aussi celle qui dépend le plus des positions naturelles dans les résultats classiques.
- AI Mode. Requêtes plus longues, décomposition en sous-requêtes bien plus détaillées, moins de liens exposés.
- Les assistants. ChatGPT, Gemini, Claude. Prompt conversationnel, mémoire, personnalisation. Et surtout, ce que le modèle a mémorisé pendant son entraînement pèse souvent plus lourd que ce qu'il va chercher sur le web au moment de répondre.
- Les moteurs de réponse, Perplexity en tête, qui récupèrent des sources de façon quasi systématique et restent donc très sensibles au référencement naturel classique, celui des résultats non payants.
Le contraste est frappant : une marque peut saturer AI Overviews et ne jamais être recommandée par ChatGPT. Nous le constatons régulièrement dans nos analyses, ce qui rappelle que les mécanismes de sélection varient fortement d'une surface à l'autre.
Les trois étapes de la visibilité IA
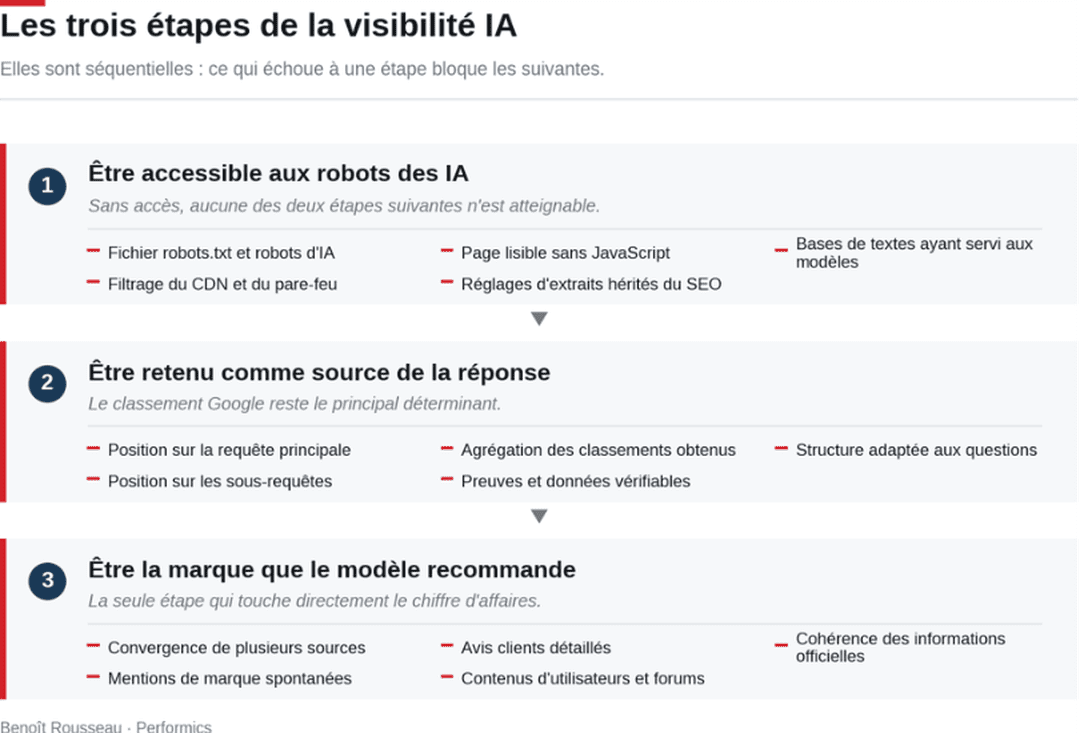
Plutôt que d'opposer les deux disciplines, je décompose la visibilité générative en trois étapes. Elles sont séquentielles : rater la première rend les deux autres inaccessibles.
Etape 1. Être accessible aux robots des IA
Pour être reprise par une IA, une page doit d'abord être récupérable et lisible. Un sujet qu'on a cessé de surveiller, et c'est précisément le problème.
Le robots.txt est devenu un sujet d'arbitrage d'entreprise, pour une raison simple : de nouveaux robots d'IA apparaissent tous les trimestres, et trois familles doivent être distinguées, parce que leurs conséquences n'ont rien à voir entre elles. Certains servent à entraîner les modèles, d'autres à alimenter leurs réponses en temps réel, d'autres encore ne se déclenchent que lorsqu'un utilisateur pose une question précise. Autoriser ou bloquer l'un n'a rien à voir avec autoriser ou bloquer les autres.
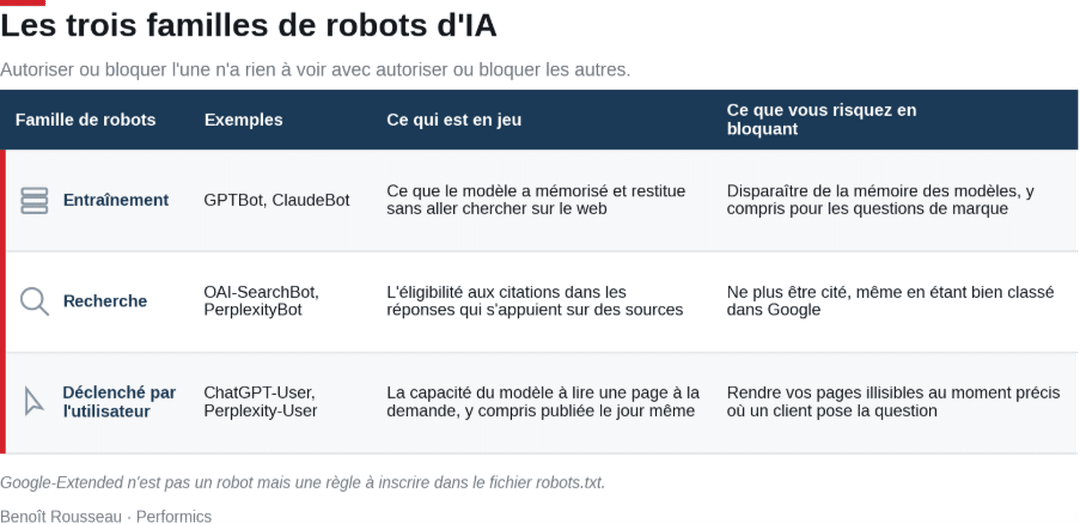
Une précision qui change la portée de l'exercice : les agents déclenchés par l'utilisateur ne se comportent pas comme des crawlers. Perplexity a défendu publiquement de ne pas respecter les consignes du fichier robots.txt pour Perplexity-User, en considérant qu'il s'agit d'une récupération à la demande et non d'un crawl d'indexation. Cloudflare l'a retiré de sa liste de bots vérifiés en août 2025 après avoir observé des contournements de blocages. Ces éléments rappellent qu’un robots.txt bien tenu encadre surtout les crawlers, et beaucoup moins certains agents.
Sur les périmètres internationaux que nous auditons, il y a presque toujours un marché où une règle locale, posée par une équipe technique ou par l'hébergeur ou le prestataire qui gère l'infrastructure, qui contredit la politique décidée au siège. Personne ne l'avait vu, pour une raison assez simple : le marketing regarde le robots.txt et la sécurité regarde le pare-feu applicatif. L'audit d'accès IA est devenu chez nous le premier livrable de toute mission GEO, avant la moindre recommandation éditoriale.
Dans les audits, les mêmes angles morts reviennent fréquemment.
- Le bot management du CDN. Une règle générique de blocage sur Cloudflare ou autre CDN peut annuler un robots.txt permissif, en filtrant à la fois l'agent déclaré et les plages d'adresses IP.
- Le rendu JavaScript. Google rend accessible le JavaScript pour ses propres fonctionnalités génératives, mais plusieurs crawlers IA tiers ne l'exécutent pas, ou mal. Le contenu commercialement décisif doit se trouver dans le HTML source des sites.
- Les réglages hérités de l'ère des snippets. Les nosnippet, max-snippet et data-nosnippet posés à partir de septembre 2019 pour maîtriser la longueur des extraits affichés sous un lien Google, à commencer par le featured snippet, limitent aujourd'hui ce qui peut apparaître dans une réponse générative : Google a étendu la portée de ces règles aux AI Overviews et à l'AI Mode.
- Les bases de textes dans lesquelles les IA ont puisé. L'index Google n'est pas la seule matière première. Plusieurs modèles IA s'appuient sur des corpus publics comme Common Crawl, où l'on peut être absent tout en étant parfaitement indexé par Google.
Etape 2. Être retenu comme source de la réponse
Quand une réponse générative cite des sources, y figurer dépend beaucoup moins d'une position que d'une couverture. Le moteur éclate la demande en sous-requêtes exécutées en arrière-plan, ce que Google et consorts nomment le query fan-out, puis agrège les classements obtenus sur chacune d'elles.
Le fan-out, comme le fait que le moteur aille chercher des sources sur le web avant de rédiger sa réponse, est documenté par Google ; le recours au Reciprocal Rank Fusion pour l'agrégation reste une hypothèse de marché, solidement étayée mais jamais confirmée officiellement. En pratique, être quatrième sur quinze sous-requêtes vaut mieux qu'être premier sur une seule.
Le modèle, par ailleurs, ne cherche pas toujours une réponse ; il cherche souvent à confirmer celle qu'il a déjà formulée, si bien qu'un contenu conforme à ce qu'il tient pour établi passe plus facilement. L’étape 2 dépend donc en partie de l’étape 3. Et sur les sujets sensibles, les moteurs se rabattent de plus en plus sur des sources reconnues (site officiel ou à forte autorité) plutôt que sur les premiers résultats disponibles.
Les leviers, eux, n'ont rien de nouveau.
- Partir des requêtes déjà positionnées, puis étendre la couverture vers leurs sous-requêtes (query fan-out). C'est la voie la plus rentable, et de très loin.
- Les questions du bloc "People also ask" font une approximation gratuite des fan-out. Largement suffisant pour démarrer avant de se lancer dans l’achat d’un outil.
- Enrichir les pages existantes plutôt que de créer une page par question. Moins coûteux et, de notre point de vue, plus efficace.
- Produire de la preuve : chiffres, méthodologie, affirmations datées. Une tribune d'opinion sans données constitue rarement un bon candidat à la citation.
- Écrire les titres comme les questions (prompts) sont réellement posées.
Un mot sur la mesure, parce que c'est là que la plupart des dispositifs s'effondrent. Je vois encore passer des baromètres bâtis sur vingt prompts, scannés une fois, et en hebdomadaire. Une même question posée deux fois ne donne pas la même réponse, et cet écart suffit à rendre la mesure ininterprétable.
En dessous de scans GEO réalisés plusieurs fois par jour, sur une période d'au moins un mois et sur plusieurs centaines de requêtes ou de prompts par marque et par marché, on ne mesure que du bruit. On construit alors tout un plan d'action, coûteux en temps et en budget, sur ce qui n'est qu'une analyse partielle.
Etape 3. La recommandation, là où le SEO ne suffit plus
Être éligible est nécessaire. Être cité en tant que source est agréable. Aucun des deux ne garantit d'être recommandé dans la réponse du LLM, et c'est pourtant la seule étape qui peut amener du trafic direct ou indirect et de la conversion.
Les moteurs construisent leurs recommandations sur une forme de consensus distribué : plusieurs sources indépendantes et jugées fiables qui convergent vers la même conclusion. Cela déplace le centre de gravité du travail en SEO et GEO.
- Du lien vers la mention. Vingt ans de netlinking ont valorisé le lien et l'ancre optimisée. La monnaie devient la citation spontanée de la marque, au bon endroit et sur le bon sujet.
- De la proximité thématique vers l'autorité réelle. Un site marginal mais bien positionné thématiquement pesait ; un site reconnu pour son expertise pèse davantage.
- Le contenu produit par les utilisateurs pèse de façon disproportionnée. Reddit, LinkedIn, YouTube et les forums spécialisés se classent très bien sur les requêtes comparatives, donc alimentent le consensus.
- Les avis changent de fonction. Ils étaient lus par le prospect au moment de décider ; ils sont lus par les LLM avant même que le prospect n'arrive. Un avis détaillé qui raconte le problème résolu vaut dix notes à cinq étoiles !
Ce que vous contrôlez compte encore, et c'est par là qu'il faut commencer, ne serait-ce que parce que c'est gratuit. Formalisez un énoncé de positionnement unique et factuel, du type « [Marque] est un [produit] conçu pour une [audience/persona], particulièrement adapté à un [cas d'usage], grâce à un [différenciateur] », puis propagez-le sans variation : accueil, pages produit, page à propos, fiches partenaires, profils LinkedIn des collaborateurs, annuaires, marketplaces, stores applicatifs, chaînes vidéo. L'incohérence entre ces différentes surfaces reste une des causes les plus banales d'absence dans les recommandations, et une des plus faciles à corriger.
C'est sur cette étape que nous créons désormais des dispositifs dédiés, distincts des plans SEO classiques : identifier les sources qui alimentent réellement le consensus sur un sujet, construire un programme d'influence sur ces sources, puis mesurer avant et après sur un corpus stable. Le levier peut être plus pertinent, à condition d’en connaître le prix : plus lent que le SEO, plus coûteux, d'un rendement variable, et avec des effets qui peuvent s'estomper plus vite.
Et c'est là que je m'écarte de la thèse des 90%. Nous ne faisons plus de l'optimisation de page, on fait de l'influence de corpus. J'emploie le terme de GEI, Generative Engine Influence, l'équivalent structurel du netlinking, à ceci près que ce qui compte n'est plus le lien, mais le fait que plusieurs sources disent la même chose de vous. Ce travail relève autant des équipes RP, social et média que des équipes SEO. Intégrer ce chantier dans un plan SEO revient à confier un sujet de marque à une équipe outillée pour produire du trafic. Concrètement, ces équipes doivent être associées dès le cadrage, pas consultées en fin de parcours.
Deux terrains que tout oppose : le luxe international et le travel
Deux secteurs montrent bien pourquoi une doctrine unique ne tient pas.
Dans le luxe international, la difficulté n'est presque jamais technique. Les maisons ont des sites irréprochables. Mais le corpus qui les décrit leur échappe en grande partie : presse spécialisée, plateformes de seconde main, forums de collectionneurs, revendeurs multimarques. Quand nous interrogeons les modèles maison par maison et marché par marché, l'écart entre l'Europe, le Golfe et l'Asie dépasse souvent celui qui sépare deux concurrents sur un même marché. Le travail utile consiste à verrouiller les faits de marque sur tout ce qui est contrôlé, puis à identifier les cinq à dix sources tierces qui font autorité dans chaque zone. On est en plein dans l’étape 3, très peu dans l’étape 2.
Dans le travel, c'est l'inverse. Les assistants y sont massivement sollicités, parce que préparer un voyage est exactement le genre de tâche qu'ils traitent bien : longue traîne, multicritère, recherche comparative. Nous y observons des décompositions en sous-requêtes bien plus profondes qu'ailleurs, un seul prompt de séjour pouvant déclencher des dizaines de recherches en arrière-plan. L'enjeu est massivement en étape 2, avec deux difficultés propres au secteur : la fraîcheur des données de service, que les modèles figent volontiers, et la construction du corpus de mesure (mots clés et prompts à suivre). Un dispositif travel bâti uniquement sur des mots-clés ne mesure rien d'utile. Il faut le compléter avec de nombreux prompts, enrichis avec des personas et des contextes de voyage explicites.
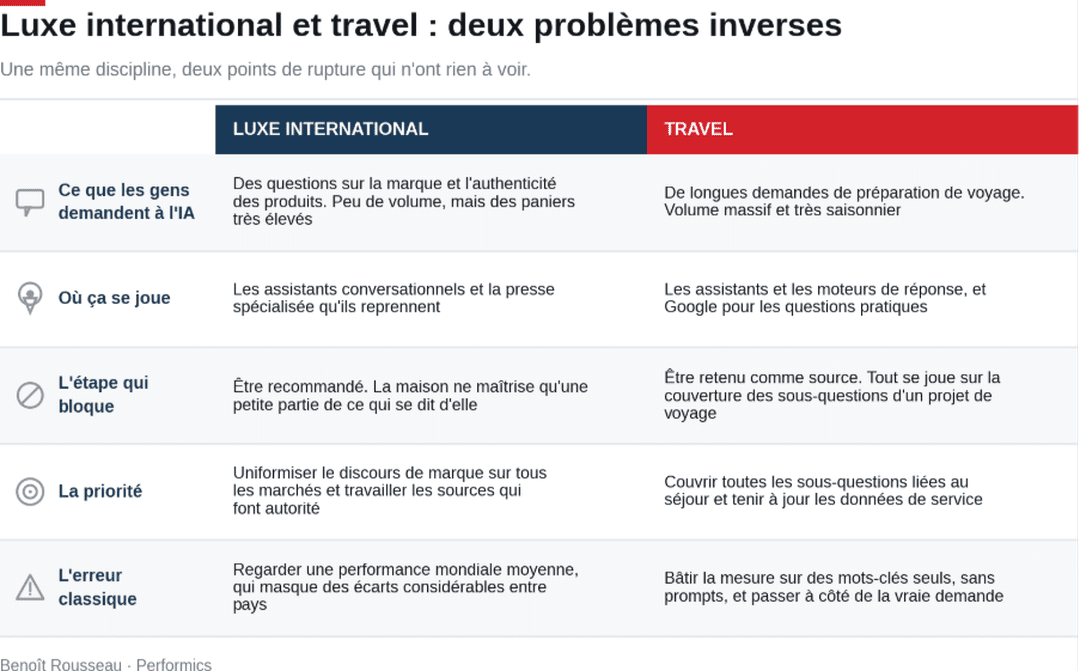
Dans les deux cas, nous travaillons sur des corpus de plusieurs centaines de requêtes et de prompts par marque et par marché, avec un protocole figé pour pouvoir comparer dans le temps. C'est la seule façon de distinguer une évolution réelle du bruit propre aux modèles.
GEA : le paid apporte au GEO la mesure qui lui manquait
Cette année, la nouveauté vient aussi du média : la publicité commence à entrer dans certains moteurs génératifs. Par symétrie avec le SEA, nous appelons ce terrain le GEA, Generative Engine Advertising. ChatGPT Ads a démarré en pilote américain en février, ouvert son self-service aux États-Unis le 5 mai, atteint neuf marchés cet été, puis a basculé sur 31 marchés européens, France comprise, annoncés le 18 août et actifs depuis le 24.
Les modalités, les marchés concernés et les partenaires varient selon les plateformes et évoluent rapidement.
L'intérêt dépasse de loin la question média. Depuis deux ans, le GEO travaille avec un angle mort méthodologique majeur : aucune plateforme ne publie de volumétrie de prompts. Il n'existe pas de Keyword Planner du prompt. Nous construisons donc les corpus par déduction, à partir des requêtes SEO, des logs de recherche interne, des questions qui arrivent au support client, des études d'usage. Nous appelons cela une hypothèse raisonnée, et personne dans la profession ne peut prétendre à mieux aujourd'hui.
Le paid, lui, produit un signal issu des plateformes elles-mêmes. Nous en tirons un protocole en quatre temps, en cours de déploiement sur nos comptes les plus avancés.
- Formuler une hypothèse de corpus de prompts, clusterisée par intention, à partir des sources organiques disponibles.
- Ouvrir une campagne courte sur ces clusters, avec un budget de découverte et non de performance.
- Croiser l'exposition et l'engagement observés en paid avec la mesure de visibilité organique sur le même corpus.
- Arbitrer. Là où le paid révèle une demande et où la marque est organiquement absente, l'investissement GEO se justifie. Là où la position organique est acquise, le paid se réduit ou se recentre sur la conquête concurrentielle.
Restent les limites, qu'il faut avoir en tête avant de surinterpréter quoi que ce soit. Les publicités ne touchent que les utilisateurs des offres gratuites et Go, donc l'échantillon ne couvre pas les abonnés payants, qui sont précisément la cible du luxe.
Le reporting ne descend pas, à ce stade, au niveau du prompt, ce qui oblige à raisonner par cluster. En Europe, le ciblage personnalisé est conditionné au consentement explicite au titre du RGPD, ce qui appauvrit encore le signal par rapport aux marchés américains. Et la pertinence contextuelle des placements reste instable, avec des diffusions hors sujet documentées début août.
Le GEA fournit donc une hiérarchie de demande plutôt qu'une volumétrie. Mais pour arbitrer un plan d’action de déploiement éditorial GEO, cela suffit.
Il y a enfin un effet de bord organisationnel. Pendant vingt ans, la synergie entre SEO et SEA a surtout servi d'argument commercial : chacun disposait de ses propres données. Sur les moteurs génératifs, l'organique n'a pas de données de demande et le paid en a. Les piloter séparément prive la stratégie éditoriale du seul signal fiable disponible.
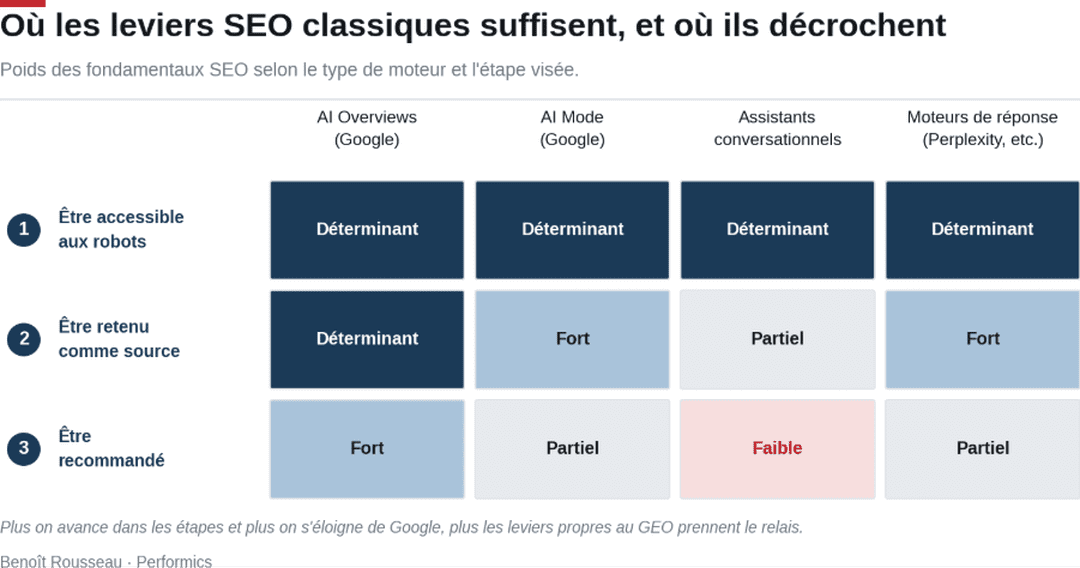
Où la thèse des 90 % tient, et où elle casse
Croisons les trois étapes et les quatre surfaces. La réponse cesse d'être binaire.
- Une gouvernance à trois entrées devient nécessaire, marketing, IT et sécurité, avec une décision écrite et une revue à date fixe.
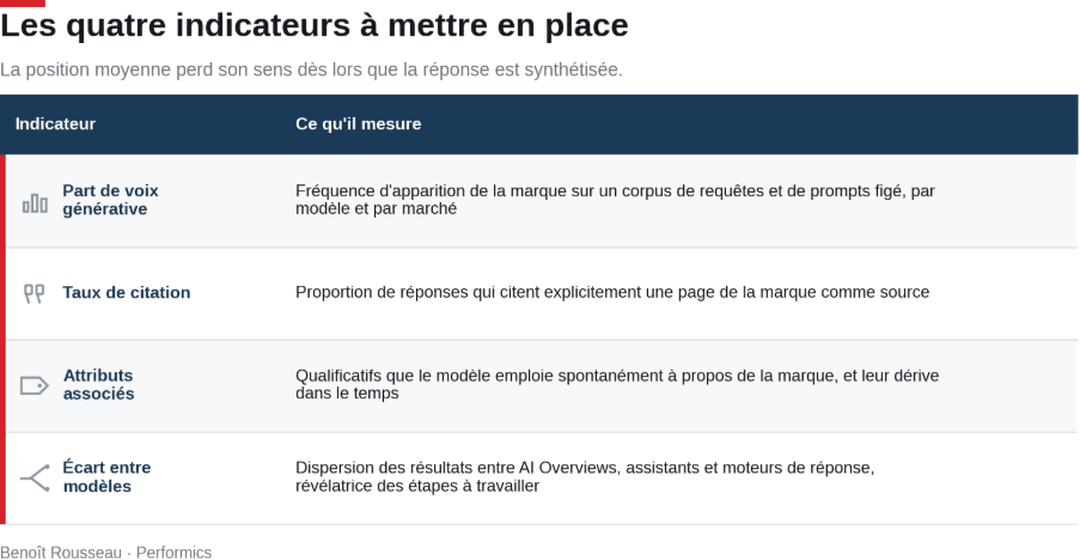
- Le référentiel de KPI doit être refait. La position moyenne perd l'essentiel de son sens dès lors que la réponse est synthétisée. En voici quelques-uns :
- Rien ne se transfère d'un marché à l'autre. Les modèles n'ont ni la même couverture ni les mêmes sources de référence selon la langue. Un dispositif conçu en France ne dit rien de l'Espagne ou du Brésil, et une mesure consolidée qui lisse cette dispersion trompe son lecteur.
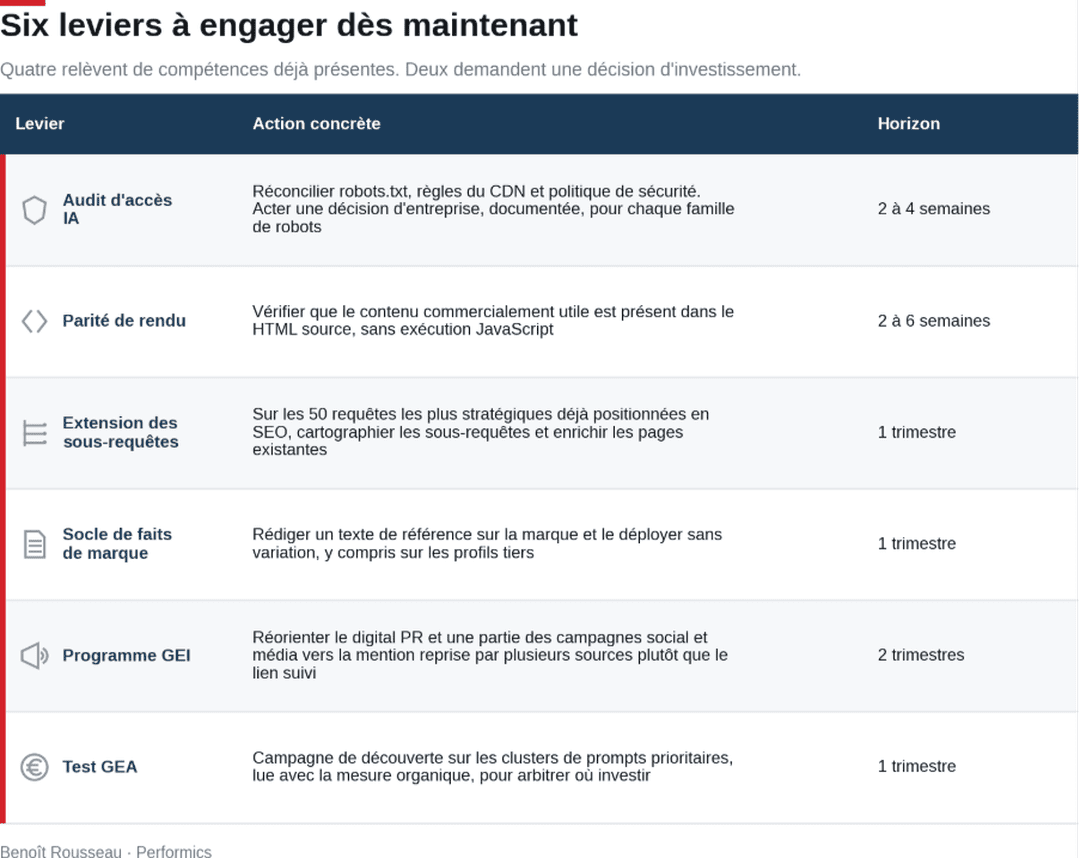
Aucun de ces six leviers n'exige de créer une équipe GEO parallèle. Quatre relèvent d'une réorientation de compétences SEO déjà présentes. Les deux derniers, le programme d'influence et le test GEA, demandent une véritable décision d'investissement, et ce sont aussi ceux que la thèse du recouvrement total entre SEO et GEO sous-estime le plus.
En comité, la bonne question n'est donc pas de savoir s'il faut faire du GEO. C'est de savoir sur laquelle des trois étapes, la marque est en train de perdre, et si l'on dispose des compétences correspondantes en interne ou chez son agence partenaire pour combler ces lacunes.
Dans la majorité des organisations que je vois passer, c'est l’étape 3 qui décroche (La recommandation). Et les compétences correspondantes ne sont pas dans les équipes en interne.