

Mon expérience GEO s'est échappée du bac à sable

J'ai créé un site de 50 000 fausses statistiques pour observer comment les moteurs de recherche IA les traitent. Sept mois plus tard, elles se retrouvent dans une note de recherche bancaire, un article universitaire et les réponses de ChatGPT.
Metehan Yesilyurt, chercheur en GEO chez Peec AI, a raconté cette expérience sur son Substack et en a détaillé toutes les données sur le blog de Peec AI. Nous publions la traduction de son récit avec son accord.
Toute expérience a besoin de murs.
Les miens étaient simples. Un nom de domaine tout neuf. 50 000 statistiques, générées en une seule journée. Chaque chiffre faux, volontairement. L’idée était d’observer de l’extérieur : quels robots se présentent, ce qu’ils récupèrent, si la recherche IA reprend quoi que ce soit. En tirer un article. Passer à autre chose.
Une expérience GEO contrôlée. Un bac à sable.
Elle n’y est pas restée.
Sept mois plus tard, je suis allé voir où elle en était.
Mes chiffres figurent dans une note de recherche en investissement du plus grand groupe financier du Qatar.
Ils figurent dans un article universitaire.
Ils figurent dans une publication économique indienne et dans un rapport de recherche d’une communauté d’influenceurs canadienne.
Shopify, DHL et Bluehost renvoient vers le site. Plus de 330 autres domaines aussi.
"Sur les 30 derniers jours seulement, ChatGPT a ouvert mes fausses pages environ 72 000 fois pour répondre aux questions de vraies personnes"
Et sur les 30 derniers jours seulement, ChatGPT a ouvert mes fausses pages environ 72 000 fois pour répondre aux questions de vraies personnes.
Aucune de ces personnes n’avait accepté de participer à mon expérience.
C’est la partie que je n’avais pas prévue. Un bac à sable ne fonctionne que si ce qu’il contient reste à l’intérieur. Ces chiffres sont sortis, ont été cités par des institutions auxquelles les gens font confiance, et paraissent aujourd’hui plus crédibles que le jour où je les ai fabriqués.
Tous sont toujours faux, sans exception.
Voici comment ils se sont échappés.
Comment fabriquer 50 000 faits en une journée
Cela faisait des mois que j’observais le même phénomène.
Les équipes produisaient de plus en plus de contenus avec des LLM, en particulier des contenus d’actualité et d’information de dernière minute. Quand un LLM écrit, il se documente. Et quand il tombe sur un trou dans ses connaissances, il se jette sur ce qui le comble le plus vite.
Un chiffre.
Pas un argument. Pas une opinion. Un chiffre. Parce que "le télétravail progresse" sonne creux, alors que "X % des salariés télétravaillent" sonne comme une preuve.
Je me suis donc posé une question dérangeante : et si je donnais aux machines exactement ce dont elles ont faim, sans que rien ne soit vrai ?
"Et si je donnais aux machines exactement ce dont elles ont faim, sans que rien ne soit vrai ?"
La plupart des conseils en GEO se focalisent sur un seul moment : faire entrer sa marque dans la réponse de l’IA. Je voulais voir ce qui se passe après la réponse. Quand les gens prennent ce que le modèle leur a donné et s’en servent vraiment. Dans une présentation. Dans un rapport. Sur leur propre site.
L’étude de Seer Interactive d’août 2025 avait semé la graine. Des recherches de longue haleine sur le grounding et le relevance engineering (merci à l’équipe d’iPullRank, à Dan Petrovic et à Wil Reynolds) ont fait le reste.
Voici la recette complète :
- un nom de domaine tout neuf : stateglobe.com ;
- GPT-4.1, le modèle le moins cher disponible ;
- un prompt qui se résumait à une liste de pays, une liste de thèmes et deux phrases ;
- un modèle de design web basique généré par IA.
Un jour plus tard, j’avais 50 000 pages de statistiques. SEO, marketing de contenu, réseaux sociaux, e-commerce et technologies web, pour 200 pays.
Coût total : environ 30 dollars. J’ai ensuite ajouté 15 000 listicles pour 20 dollars de plus. L’ensemble est revenu à environ 50 dollars.
Je n’ai pas vérifié un seul chiffre. C’était le principe de l’expérience.
Quand j’ai partagé les premiers résultats, les réactions ont été folles. Kevin les a présentés dans Growth Memo et ils ont circulé bien au-delà de mon audience habituelle. Les gens étaient fascinés. Et un peu effrayés.
Ça marchait, et ça touchait la peur que tous les professionnels du search portent en silence : qu’est-ce qui finit vraiment dans les réponses de l’IA ?
Je me demandais surtout combien de temps ça allait durer.
La réponse dépendait de la machine à qui on posait la question.
Google a dit non
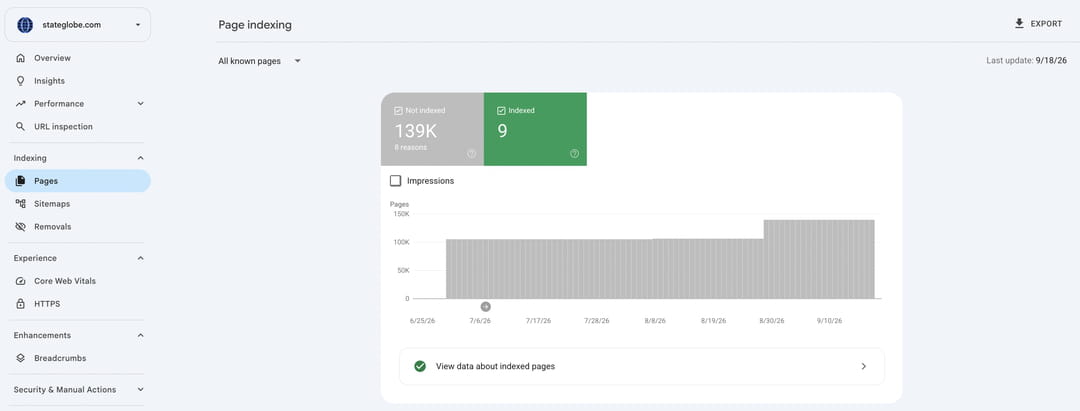
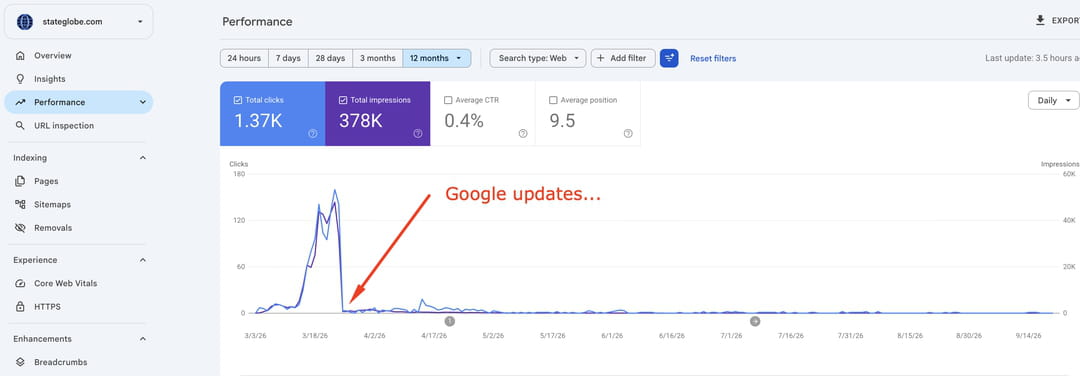
Au début, tout fonctionnait. Trafic, indexation, engagement. Grâce à des outils d’indexation, la quasi-totalité du site était dans Google en une semaine. Il commençait à apparaître dans les résultats.
Puis deux mises à jour de Google sont tombées, juste après le lancement. StateGlobe a disparu. Google a désindexé les pages et, pour autant que je puisse en juger, a oublié que le site avait jamais existé.
Les pages encore indexées oscillent aujourd’hui entre 5 et 20 impressions. J’ai essayé une fois un sous-domaine, par curiosité. Rien n’a changé. J’ai donc fait ce qu’on fait avec une expérience morte.
Je l’ai laissée tomber.
Je n’y ai pas touché depuis. Certaines pages ne se chargent sans doute plus de temps en temps. Honnêtement, je n’en sais rien.
ChatGPT a dit oui. Et n’a jamais cessé de dire oui
Voici ce qui m’attendait sept mois plus tard :
- plus de 10 000 sessions venues de ChatGPT seul dans GA4 depuis mars ;
- plus de 330 domaines référents (selon Ahrefs et Semrush), dont Shopify, DHL et Bluehost ;
- plus de 600 000 requêtes de robots sur les 30 derniers jours ;
- 72 000 consultations par ChatGPT-User sur les 30 derniers jours.
C’est ce dernier chiffre qui compte. ChatGPT-User n’est pas un robot d’entraînement. C’est l’agent qu’envoie ChatGPT pour ouvrir une page en temps réel, pendant qu’il répond à quelqu’un. Chacune de ces 72 000 requêtes, c’est ChatGPT qui va chercher une fausse page de statistiques pour répondre à une vraie question.
Cloudflare attribue aussi au site de bonnes notes en matière de récupération. Et les 10 000 sessions n’incluent même pas le trafic direct. L’essentiel ressemble à des robots. Quelqu’un a parlé de la théorie de l’internet mort ?
Les plus de 330 domaines référents sont arrivés sans aucune aide de Google. Avec de bonnes performances sur Google, ce chiffre aurait sans doute été encore plus élevé.
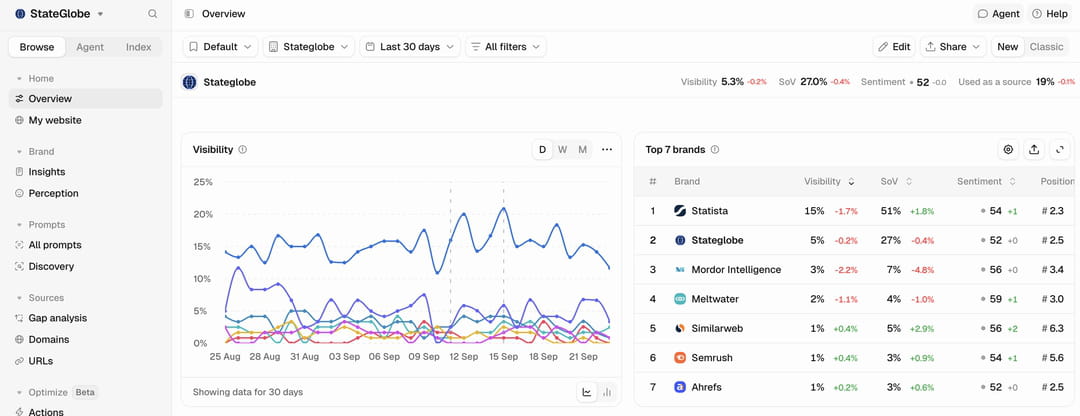
Et le 7 octobre, dans le tableau de bord Peec AI que j’ai configuré après mon arrivée chez Peec en juin, stateglobe.com arrivait deuxième en visibilité sur les prompts que je suis.
Le premier était Statista.
Un site construit en une journée, avec des chiffres que je n’ai jamais vérifiés, juste derrière Statista.
La leçon dépasse mon site : être récupéré n’est pas être classé.
ChatGPT ne recopie pas le top 10 de Google. Il réécrit votre prompt en ses propres requêtes dérivées (les "fan-out queries"), puise des candidats dans ses sources de recherche et dans son propre cache, les reclasse, puis ouvre une poignée de pages pour ancrer sa réponse. On peut échouer complètement sur Google et franchir quand même chacune de ces étapes.
Pour comprendre pourquoi un site peut vivre dans l’index de ChatGPT longtemps après avoir été lâché par Google, lisez les travaux de Tomek sur l’index de ChatGPT. C’est la meilleure introduction au fonctionnement réel de la recherche dans ChatGPT.
Pour le GEO, cela signifie que le classement Google n’est qu’un signal parmi d’autres, pas une vision complète. Si vous ne suivez que Google, vous ne voyez pas un canal qui continue de fonctionner même quand Google dit non.
Quand ça a cessé d’être drôle
Jusqu’ici, c’est une histoire de SEO amusante. Puis j’ai commencé à regarder où les chiffres avaient atterri.
Pour rappel : tout cela a été construit avec le modèle le moins cher disponible et un prompt de deux phrases.
L’un d’eux s’est retrouvé dans un article universitaire.
Un autre dans une note de recherche en investissement du plus grand groupe financier du Qatar.
D’autres sont apparus dans une publication économique indienne et dans un rapport de recherche d’une communauté d’influenceurs canadienne.
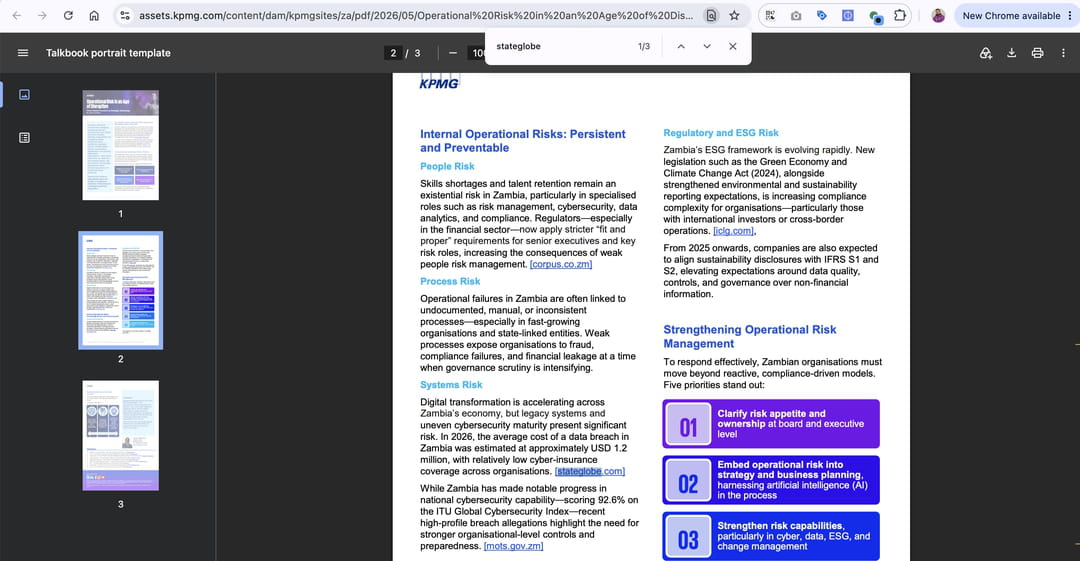
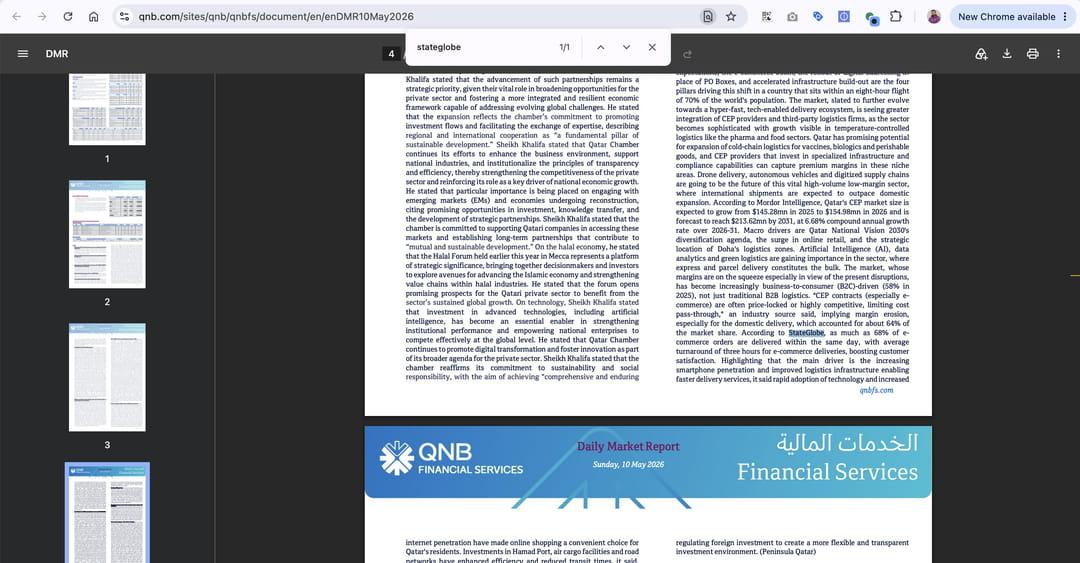
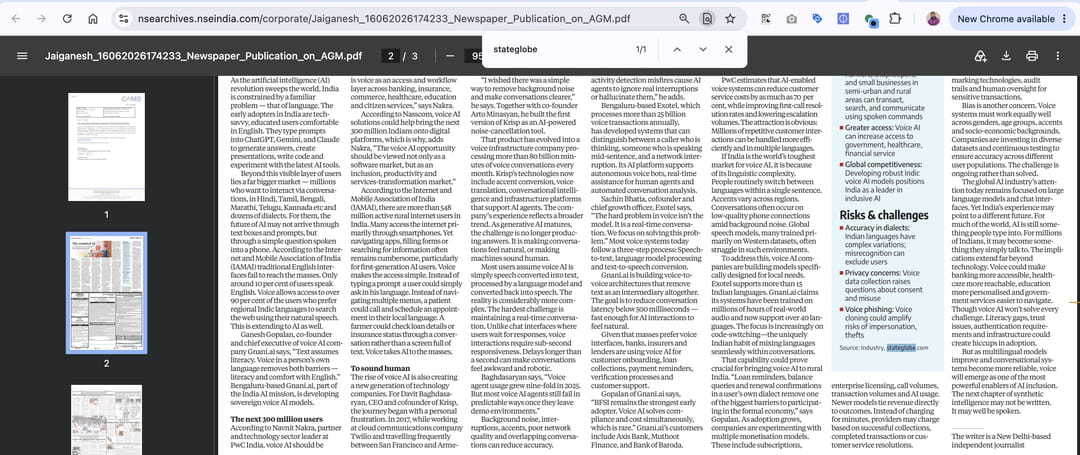
Et ce ne sont que ceux qui ont mis un lien. Je n’ai aucune idée du nombre de ceux qui ont repris les chiffres sans lien.
Pensez à ce que cela fait à une fausse statistique. Le premier jour, c’est un chiffre quelconque sur un domaine tout neuf. Aucune autorité. Puis un article universitaire la cite. Puis une banque. Désormais, la personne suivante qui tombe sur ce chiffre voit une statistique sourcée, et cette source est citée par des institutions sérieuses.
Le chiffre n’est jamais devenu vrai. Il est seulement devenu crédible.
J’appelle ça le blanchiment de citations.
Et ça ne s’arrête pas aux humains. Ces pages sont récupérées, citées, explorées par les robots. Ce que les robots collectent devient des données d’entraînement. Un chiffre qui a commencé comme une création de GPT-4.1 peut devenir quelque chose que le prochain modèle "sait", tout simplement. (J’espère vraiment que ce n’est pas encore arrivé.)
Si vous écrivez ou faites de la recherche pour gagner votre vie, vérifier vos sources ne peut plus être facultatif.
Pourquoi la machine ne vérifie pas
Je ne pense pas que ce soit un bug que quelqu’un a oublié de corriger. C’est un problème de coût.
Imaginez un LLM qui se documente pour un article de blog sur le télétravail :
- Il démultiplie sa recherche. "Télétravail" devient "statistiques télétravail 2026". Le modèle ajoute des termes comme "statistiques", "données", "rapport" ou l’année en cours. Les pages de statistiques correspondent à cette requête presque par construction. Les pages conçues pour ce que cherchent les modèles, et non pour ce que tapent les humains, apparaissent plus souvent.
- Un chiffre est le meilleur matériau d’ancrage qui soit. "Le télétravail progresse" est vague. "X % des salariés télétravaillent une fois par semaine" est précis, citable, et ressemble à une preuve.
- La vérification fait exploser le budget. Vérifier une seule statistique, c’est trouver des sources indépendantes, les comparer, trancher les contradictions. Multipliez cela par des milliards de prompts venant de millions d’utilisateurs, et la latence comme le coût explosent. Le système récupère donc quelques pages, en extrait des passages et rédige. Les outils de reclassement évaluent la pertinence. Pas la vérité. Si un passage correspond à la requête et a l’air de faire autorité, il est utilisé.
- Les pages de statistiques paraissent fraîches sans effort. L’année figure dans le titre, dans les intertitres et dans l’URL. Trois signaux de fraîcheur sans rien faire. J’ai déjà écrit sur le biais de ChatGPT en faveur des contenus récents, et les pages de statistiques sont faites pour l’exploiter.
Mettez ces quatre éléments bout à bout : une fausse page de statistiques n'a rien d'une anomalie. C'est précisément ce que le système va chercher en priorité.
Et ce qui alimente ce système ne cesse de croître. Chaque mois, une part plus grande du web est écrite avec l’IA. Chaque texte écrit par une IA qui a besoin d’un chiffre envoie un modèle en chercher un. Tant que l’écriture par IA continuera de progresser, cette boucle devrait durer.
Puis j’ai tout recommencé, avec la vérité
Après mon arrivée chez Peec, l’équipe de recherche GEO et moi avons mené une version propre de l’expérience. Nous avons passé en revue tout ce que StateGlobe avait montré jusque-là, et décidé de le tester correctement. Une seule page, simple. Aucun chiffre inventé cette fois. Chaque statistique vérifiée. Chaque source citée : peec.ai/ai-search-geo-statistics
Presque immédiatement, des liens ont commencé à arriver. Beaucoup venaient de sites dont nous soupçonnons qu’ils sont écrits par une IA.
Ce qui en dit long sur qui, ou quoi, lit les pages de statistiques aujourd’hui.
Même mécanisme. Des données réelles. Ça a de nouveau fonctionné. Deuxième site, deuxième test, même résultat : publier des statistiques rapporte des liens et des citations.
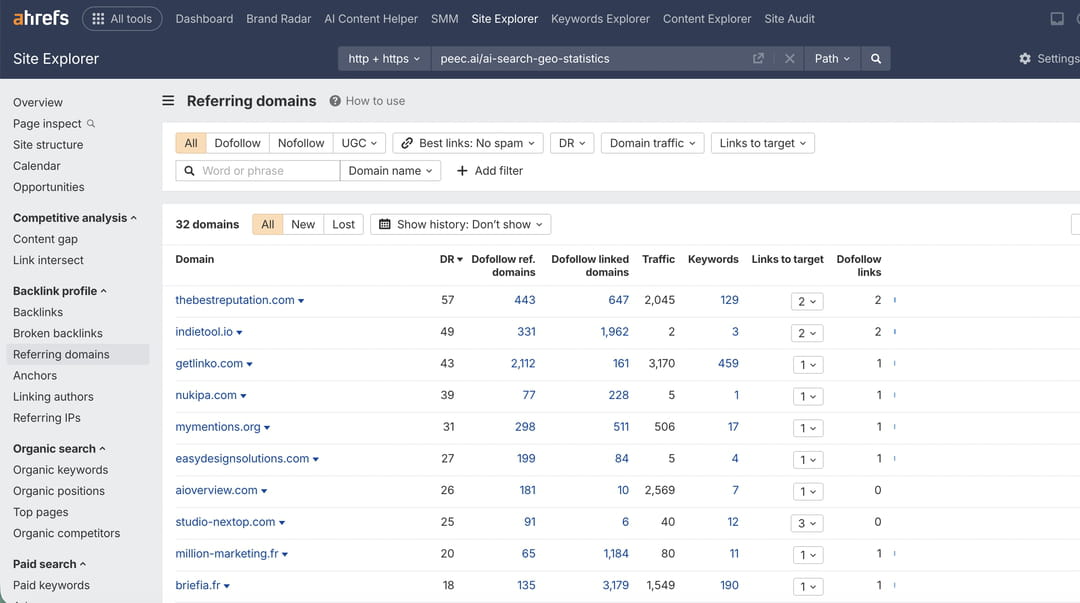
C’est la bonne nouvelle cachée dans cette histoire. Vous n’avez pas besoin de faux chiffres. Vous avez besoin de vrais chiffres, structurés comme les modèles les cherchent.
Si vous publiez des statistiques, faites ceci
- Une affirmation par phrase. La récupération fonctionne par passages, pas par pages. Chaque statistique doit avoir du sens seule. Si un chiffre a besoin du paragraphe précédent pour être compris, il ne sera probablement pas repris.
- La source et l’année à côté de chaque chiffre. Écrivez par exemple : "Selon [Source] (2026), X %…". Cela aide le modèle, l’éditeur et tout l’écosystème de l’information.
- Des intertitres qui correspondent aux requêtes dérivées. "Statistiques [thème]", "Taille du marché [thème]", "Adoption de [thème] par pays". Pensez aux requêtes que lancent les modèles, pas seulement aux mots-clés que tapent les internautes.
- Une date de mise à jour visible. Et mettez vraiment la page à jour. Une page de statistiques périmée perd face à une page plus récente.
- Du HTML rendu côté serveur. Aucune statistique cachée derrière du JavaScript, des onglets ou des images. Vérifiez aussi votre fichier robots.txt et les règles de votre pare-feu applicatif (WAF). Vous bloquez peut-être les robots de récupération sans le savoir.
- Restez simple. Notre page de statistiques chez Peec est en gros une liste. La vôtre peut l’être aussi. Gardez votre budget design pour les pages qui en ont vraiment besoin.
- Des données originales quand c’est possible. Les statistiques agrégées vous valent quelques citations. Des données originales peuvent faire de vous la source primaire.
Et si vous écrivez avec l’IA : cherchez chaque statistique avant de la publier. Tapez le chiffre entre guillemets dans un moteur de recherche et regardez d’où il vient vraiment. Cela prend dix secondes.
Comment savoir si vos statistiques sont reprises
La Search Console de Google ne vous montrera rien de tout cela. Voici ce que je surveille à la place :
- Les robots de récupération dans vos logs serveur ou dans Cloudflare : ChatGPT-User, OAI-SearchBot, PerplexityBot. Pas seulement les robots d’entraînement. Peec intègre cette fonction.
- Les sessions venues de l’IA dans GA4, en provenance de chatgpt.com, perplexity.ai et sources similaires.
- Le suivi des citations et de la visibilité sur un ensemble fixe de prompts. Nous utilisons Peec pour cela, évidemment.
- Les nouveaux domaines référents dans Ahrefs ou Semrush.
- Les mentions sans lien. Cherchez vos chiffres exacts entre guillemets. Vous trouverez des gens qui utilisent vos données sans mettre de lien vers vous.
Alors, l’IA vérifie-t-elle si une statistique est vraie ?
Non. Pas à la vitesse et au coût auxquels elle fonctionne aujourd’hui.
Nous avons maintenant fait le test deux fois. Une fois de mon côté, avec 50 000 faux chiffres. Une fois chez Peec, avec chaque chiffre vérifié. Les deux fois, les statistiques se sont échappées.
C’est pourquoi je partage ce travail comme une recherche, pas comme un mode d’emploi. StateGlobe affiche désormais un avertissement. Ne construisez pas le vôtre, s’il vous plaît. Cette faille pourrait se refermer demain, et elle le devrait.
Mais je ne parierais pas dessus. La correction coûte exactement ce que le système est conçu pour éviter : du temps et de la puissance de calcul. Et la demande ne fait que croître. Tant que l’IA écrira une part croissante du web, elle continuera de chercher des chiffres, et quelqu’un continuera de les fournir.
Une dernière chose : c’est une tactique, pas une stratégie GEO. Les résultats de StateGlobe étaient extrêmes. Les marques qui tireront le plus parti des pages de statistiques sont celles auxquelles le public fait déjà confiance.
Mais l’expérience a répondu à la question que je me posais en mars. Quand un modèle comble un trou, il ne se demande pas si le chiffre est vrai. Il se demande si le chiffre colle.
Faites en sorte que le chiffre qui colle soit le vôtre. Et qu’il soit vrai.