

Comment l'IA identifie votre marque: importance des entités dans le GEO

Comment les IA reconnaissent votre marque comme entité : données Ahrefs sur 75 000 marques, ce que schema et sameAs font vraiment, et un plan en 7 étapes pour être plus clair et plus cité par l'IA.
En bref
Les moteurs génératifs ne classent pas des pages, ils reconnaissent des choses. Une entité est une chose identifiable de façon unique : votre entreprise, un fondateur, un produit. Une marque que le modèle ne sait pas identifier clairement risque d’être absente des réponses ou confondue avec une autre.
- Les mentions devancent les liens comme corrélat. Les mentions de marque sur le web corrèlent à 0,664 avec les mentions en AI Overviews, contre 0,218 pour les backlinks (Ahrefs, 75 000 marques, 2025).
- Le quart supérieur domine. Les marques les plus mentionnées totalisent en moyenne 169 mentions en AI Overviews, contre 14 pour le quart suivant.
- Le balisage schema n’est pas un levier magique. Bing dit qu’il aide ses LLM. Google dit qu’aucun balisage spécial n’est requis pour les AI Overviews et le mode IA.
- Aucune preuve indépendante qu’une présence dans le Knowledge Graph ou sur Wikidata augmente les citations par les IA.
- Tactiques de contenu les mieux démontrées (recherche GEO, 2024) : ajouter des citations (+39,5 %) et des statistiques (+29,2 %). Les entités n’ont pas été testées.
- Le plan : définir, désambiguïser, relier, obtenir des mentions, mesurer.
Qu’est-ce qu’une entité en GEO ?
Une entité est une chose que l’on peut identifier sans ambiguïté : une entreprise, une personne, un produit, un lieu ou un concept. Elle existe indépendamment des mots utilisés pour la nommer. "Apple" le fruit et "Apple" l’entreprise technologique sont deux entités qui partagent un mot.
Le GEO (Generative Engine Optimization) consiste à rendre une marque et ses contenus visibles, et correctement décrits, dans les réponses générées par l’IA. Le terme a été formalisé dans l’article de recherche GEO: Generative Engine Optimization (Aggarwal et al., KDD 2024). Les entités comptent pour le GEO parce qu’une réponse d’IA s’organise autour de choses nommées : quels produits existent, quelle marque les fabrique, quelles marques sont concurrentes.
Ce que c’est
- Mot-clé: Une chaîne de texte tapée par les internautes
- Entité: Une chose identifiée de façon unique
Ambiguïté
- Mot-clé: Forte (un mot, plusieurs sens)
- Entité: Levée (une identité, plusieurs noms)
Exemple
- Mot-clé: "logiciel de paie"
- Entité: Un éditeur précis, son fondateur, son produit
Comment agir dessus
- Mot-clé: Texte des pages, titres, ancres
- Entité: Nommage cohérent, balisage, profils, mentions tierces
Où cela vit
- Mot-clé: Index de recherche
- Entité: Bases de connaissances, mémoire du modèle, sources récupérées
Pourquoi les entités comptent-elles plus dans les réponses d’IA ?
Dans une liste de dix liens bleus, une marque mal identifiée perdait quelques places. Dans une réponse rédigée d’un seul bloc, elle peut être absente ou fusionnée avec un homonyme. Le modèle n’a pas de page deux.
Les moteurs de recherche stockent des entités dans des bases de connaissances depuis des années. En mai 2020, Google indiquait que son Knowledge Graph contenait plus de 500 milliards de faits sur cinq milliards d’entités. Les faits proviennent d’informations partagées sur le web, de bases ouvertes et de bases sous licence. Google précise que Wikipédia est souvent citée mais n’est pas la seule source. La base de connaissances ouverte Wikidata compte environ 122 millions d’éléments, selon les statistiques Wikimedia de 2026.
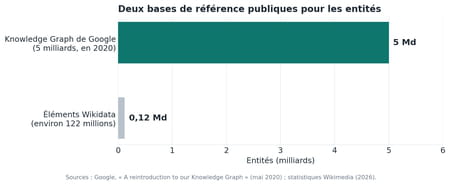
Figure 1. Deux bases de référence publiques pour les entités. Sources : Google (mai 2020) ; statistiques Wikimedia (2026).
Google note aussi que de nombreux panneaux de connaissances peuvent être revendiqués par leur sujet via un processus de vérification. C’est l’un des rares leviers officiels et directs dont dispose une marque sur sa fiche d’entité.
Comment les moteurs d’IA reconnaissent-ils une marque ?
À lire d’abord
Aucun éditeur ne publie la façon dont ChatGPT, Gemini ou Perplexity résolvent les entités. Ce qui suit combine recherches publiées et corrélations mesurées. Ce qui relève de l’inférence est signalé.
Un modèle porte plusieurs visions d’une marque à la fois.
- La mémoire paramétrique. Ce que le modèle a absorbé à l’entraînement. Votre marque y est représentée par des associations statistiques entre son nom et d’autres mots, marques et concepts. Elle évolue lentement, et publier une page ne la réécrit pas.
- La recherche en direct. Quand un assistant interroge le web ou un index, il récupère des passages et les reformule. Une identité claire aide le système à savoir de quelle entité parle chaque source. (Inférence.)
- Les structures en graphe. Certains systèmes de recherche construisent un graphe d’entités et de relations. L’article GraphRAG de Microsoft Research décrit l’extraction d’entités d’un corpus, leur regroupement puis le résumé de chaque groupe. Sur des corpus d’environ un million de tokens, les auteurs rapportent une meilleure exhaustivité et diversité que la recherche classique. C’est une méthode de recherche, pas la description d’un assistant commercial.
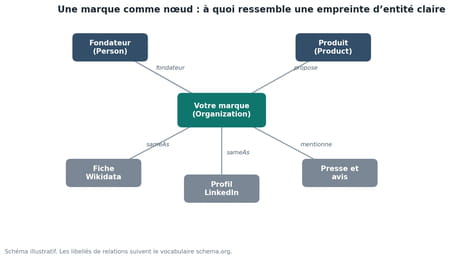
Figure 2. Une empreinte d’entité claire : un nœud de marque relié aux personnes, produits, profils d’identité et couvertures tierces.
Les mentions de marque comptent-elles plus que les backlinks ?
La mesure la plus citée vient d’Ahrefs. En mai 2025, l’entreprise a publié une analyse de 75 000 marques, qui met en regard des signaux de marque et les mentions de chaque marque dans les AI Overviews de Google. Les mentions de marque sur le web arrivent en tête.
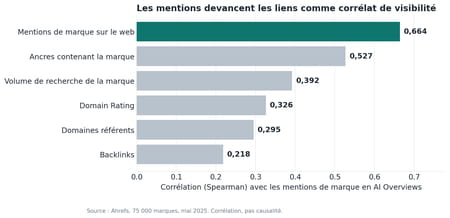
Figure 3. Corrélation de chaque facteur avec les mentions de marque en AI Overviews. Source : Ahrefs, mai 2025.
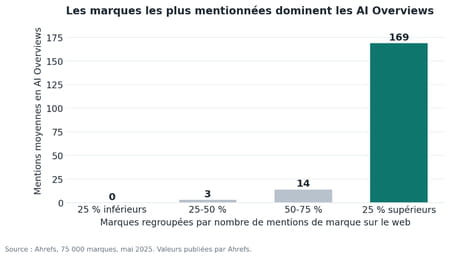
Figure 4. Mentions moyennes en AI Overviews par quartile de mentions de marque sur le web. Source : Ahrefs, mai 2025.
Comment le lire. Ce qui corrèle le plus, c’est la fréquence à laquelle votre nom apparaît ailleurs sur le web, dans un même contexte, plus que le nombre de liens qui pointent vers vous. Cela colle à une logique d’entité : plus un nom revient dans des contextes cohérents, plus l’objet est stable.
Limites. Ahrefs souligne lui-même que corrélation n’est pas causalité, que toutes les corrélations sont modérées à faibles, et que les AI Overviews sont encore expérimentaux. L’échantillon est aussi limité aux marques dont le Domain Rating dépasse 40, donc des acteurs établis. Les conclusions ne se transposent pas automatiquement à une jeune marque.
Sur quelles sources les moteurs d’IA s’appuient-ils ?
Une étude Semrush (novembre 2025) a suivi chaque semaine les domaines les plus cités par ChatGPT search, le mode IA de Google et Perplexity, sur environ 230 000 requêtes et 13 semaines. Les leaders diffèrent selon la plateforme.
- ChatGPT: Wikipédia, Reddit, Medium, Forbes, LinkedIn
- Mode IA de Google: LinkedIn, YouTube, Reddit, Google, Google Blog
- Perplexity: Reddit, LinkedIn, NIH, Microsoft, Google
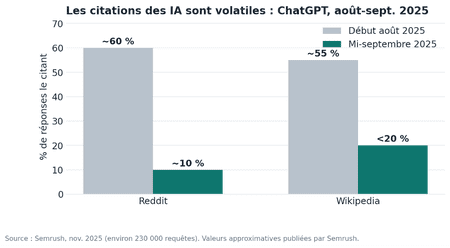
Figure 5. Les citations de Reddit et Wikipédia par ChatGPT ont chuté en septembre 2025. Source : Semrush, valeurs approximatives.
La leçon est double. Votre entité doit être décrite de façon cohérente sur les plateformes que chaque moteur lit réellement. Et les schémas de citation bougent vite : dans cette étude, les citations de Reddit et Wikipédia par ChatGPT ont chuté en quelques semaines, sans changement équivalent sur le mode IA ou Perplexity. Prévoyez un suivi, pas une correction unique.
Les données structurées et sameAs aident-ils ?
C’est là que les discours commerciaux vont le plus loin. Le raisonnement séduisant : "les IA veulent des entités, donc balisez-les et elles vous citeront". Voici sur quoi repose chaque affirmation.
Le balisage schema aide les LLM de Bing et Copilot à comprendre le contenu
- Preuve: Fabrice Canel (Bing), SMX Munich, mars 2025, relayé par Search Engine Land
- Statut: Déclaré par l’éditeur, Microsoft uniquement
Le balisage Organization aide Google à identifier et distinguer une organisation
- Preuve: Documentation Organization de Google
- Statut: Documenté pour Google Search
Un schema spécial est nécessaire pour les AI Overviews ou le mode IA
- Preuve: Le guide des fonctionnalités IA de Google dit que non
- Statut: Contredit par Google
sameAs pointe vers une page qui identifie l’entité
- Preuve: Définition schema.org : une page de référence qui indique sans ambiguïté l’identité de l’élément, comme une page Wikipédia, une fiche Wikidata ou un site officiel
- Statut: Standard défini
Être dans le Knowledge Graph ou sur Wikidata augmente les citations par les IA
- Preuve: Aucune étude indépendante trouvée. Des chiffres comme "2,7 fois plus de citations" circulent sur des blogs d’agences sans méthode
- Statut: Non prouvé
Les mentions de marque vont de pair avec une visibilité IA plus forte
- Preuve: Ahrefs, 75 000 marques
- Statut: Corrélationnel
Verdict. Balisez vos entités parce que c’est peu coûteux, que cela lève des ambiguïtés et que cela correspond au contenu visible, ce que Google demande. N’en attendez pas une citation garantie. Google précise aussi qu’aucun nouveau fichier lisible par machine ni balisage propre à l’IA n’est nécessaire pour apparaître dans ses fonctionnalités IA.
Un bloc Organization minimal et exact ressemble à ceci. Remplacez chaque valeur par vos données réelles, et ne listez que des profils qui décrivent vraiment la même entité.
{
"@context": "https://schema.org",
"@type": "Organization",
"@id": "https://www.exemple.fr/#organization",
"name": "Exemple SAS",
"url": "https://www.exemple.fr/",
"description": "Exemple SAS édite un logiciel de paie pour les entreprises de taille moyenne.",
"founder": { "@type": "Person", "name": "Jeanne Dupont" },
"sameAs": [
"https://www.wikidata.org/wiki/Q000000",
"https://www.linkedin.com/company/exemple-sas"
]
}
Qu’apporte la recherche sur le GEO ?
L’article fondateur du GEO a testé neuf tactiques de contenu sur GEO-bench, un jeu de 10 000 requêtes couvrant 25 domaines. Les auteurs indiquent que le GEO peut augmenter la visibilité "jusqu’à 40 %". Le tableau publié donne des scores absolus. Les pourcentages ci-dessous sont calculés à partir de ces scores, par rapport à la référence sans optimisation.
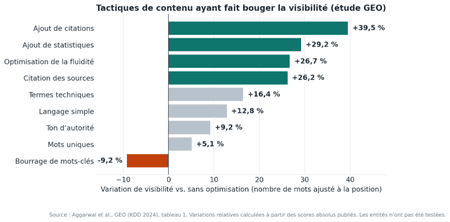
Figure 6. Variation de visibilité par tactique de contenu. Source : Aggarwal et al., tableau 1 ; pourcentages calculés.
- Citations et statistiques en tête. Les pages qui citent des sources et des chiffres étaient reprises plus souvent.
- Le bourrage de mots-clés pénalise. Il a obtenu un score inférieur à la référence, à −9,2 %.
- Sur Perplexity, le test en conditions réelles de l’article va dans le même sens : ajout de citations environ +21 % et ajout de statistiques environ +9 % (calculés), tandis que le bourrage de mots-clés baisse d’environ 9 %.
- Les entités n’ont pas été testées. L’article ne dit rien d’exploitable directement sur le balisage ou le Knowledge Graph. Lisez-le comme un guide pour rendre vos pages citables, pas pour optimiser les entités.
Comment construire une empreinte d’entité solide ?
Écartez ce qui n’est pas prouvé : il reste un plan sain, fondé sur la clarté plutôt que sur les astuces. Considérez l’ordre comme une liste de priorités.
1. Définissez votre identité canonique. Écrivez une phrase couvrant catégorie, cible et différenciateur, par exemple "Exemple SAS édite un logiciel de paie pour les entreprises de taille moyenne". Utilisez-la partout. Les modèles apprennent par des formulations répétées et stables.
2. Fixez le nom. Un nom officiel, une orthographe, une URL canonique. Évitez les noms abrégés ou alternatifs dans vos propres textes.
3. Balisez l’Organization. Balisage Organization complet avec sameAs vers de vrais profils, en cohérence avec le contenu visible de la page.
4. Créez des pages d’entités de soutien. Donnez au fondateur, aux produits clés et à la direction leur propre page, reliée aux autres et à la marque.
5. Revendiquez et vérifiez vos profils. Vérifiez votre panneau de connaissances Google si vous êtes éligible, complétez LinkedIn et les annuaires sectoriels, et n’ajoutez un élément Wikidata que si vous respectez ses règles d’inclusion.
6. Obtenez des mentions tierces authentiques. Médias sectoriels, citations d’experts, avis, comparatifs, participation sincère aux communautés. C’est le signal le mieux documenté.
7. Rendez vos pages citables. Ajoutez des citations attribuées, des statistiques sourcées et un langage clair, les tactiques les plus performantes de l’étude GEO.
Quelles sont les erreurs d’entité les plus courantes ?
Descriptions de marque différentes selon les canaux
- Pourquoi c’est nuisible: Affaiblit l’association stable que le modèle peut apprendre
- Correction: Une description canonique, réutilisée
- sameAs vers des profils erronés ou non officiels
- Pourquoi c’est nuisible: Relie votre entité à une autre
- Correction: Ne lister que des profils que vous contrôlez ou qui correspondent vraiment
- Balisage qui ne correspond pas à la page visible
- Pourquoi c’est nuisible: Google demande que le balisage corresponde au texte visible
- Correction: Ne baliser que ce que voit l’utilisateur
- Traiter schema comme une garantie de citation
- Pourquoi c’est nuisible: Aucune preuve que ce soit le cas
- Correction: Le traiter comme de l’hygiène, mesurer les résultats
- Acheter ou fabriquer des mentions
- Pourquoi c’est nuisible: Signal de faible qualité, risque de réputation et de plateforme
- Correction: Obtenir des mentions éditoriales et clients
- Un effort unique
- Pourquoi c’est nuisible: Les schémas de citation changent en quelques semaines
- Correction: Suivi mensuel
Comment mesurer sa visibilité d’entité dans les réponses d’IA ?
Posez à plusieurs assistants les questions que vos clients posent. Pour chacune, notez si vous êtes cité, comment vous êtes décrit et quels concurrents apparaissent à vos côtés. Répétez chaque mois sur un panel fixe de 20 à 30 requêtes. Les réponses varient d’une exécution à l’autre : regardez les tendances, pas les résultats isolés. Des outils comme Ahrefs Brand Radar automatisent une partie du suivi, mais un tableur suffit pour commencer.
meilleur logiciel de paie pour 80 salariés
- Plateforme: ChatGPT
- Date: 2026-11-06
- Cité ?: Oui / Non
- Description exacte ?: Oui / En partie / Non
- Concurrents nommés: A, B, C
qu’est-ce qu’Exemple SAS
- Plateforme: Perplexity
- Date: 2026-11-06
- Cité ?: Oui / Non
- Description exacte ?: Oui / En partie / Non
- Concurrents nommés: -
- Taux de citation : part des requêtes du panel où vous êtes nommé.
- Taux d’exactitude : part des mentions qui vous décrivent correctement.
- Ensemble d’associations : quelles marques et catégories apparaissent à côté de la vôtre.
Checklist : empreinte d’entité
☐ Une définition de marque en une phrase, identique sur tous les canaux
☐ Un nom officiel et une orthographe, une URL canonique
☐ Balisage Organization complet, avec de vrais liens sameAs
☐ Fondateur, produits et direction ont des pages reliées
☐ Panneau de connaissances et profils clés vérifiés
☐ Les pages contiennent des citations attribuées et des statistiques sourcées
☐ Suivi mensuel de 20 à 30 requêtes sur 3 assistants
Chiffres clés
- Mentions de marque sur le web vs mentions en AI Overviews (corrélation): 0,664 (Ahrefs, mai 2025)
- Backlinks vs mentions en AI Overviews (corrélation): 0,218 (Ahrefs, mai 2025)
- Mentions moyennes en AI Overviews, quart supérieur vs suivant: 169 vs 14 (Ahrefs, mai 2025)
- Taille du Knowledge Graph de Google: 500 Md+ de faits, 5 Md d’entités (Google, mai 2020)
- Taille de Wikidata: environ 122 millions d’éléments (Wikimedia, 2026)
- Ajout de citations vs référence (calculé): +39,5 % (Aggarwal et al., 2024)
- Ajout de statistiques vs référence (calculé): +29,2 % (Aggarwal et al., 2024)
- Bourrage de mots-clés vs référence (calculé): −9,2 % (Aggarwal et al., 2024)
Sources
· Ahrefs, An Analysis of AI Overview Brand Visibility Factors (75K Brands Studied), 26 mai 2025
· Aggarwal et al., GEO: Generative Engine Optimization, KDD 2024 (arXiv 2311.09735)
· Google, A reintroduction to our Knowledge Graph and knowledge panels, 20 mai 2020
· Google Search Central, AI features and your website
· Google Search Central, Organization structured data
· Semrush, Most-cited domains in AI search, 10 nov. 2025
· Search Engine Land, Microsoft Bing/Copilot use schema for its LLMs, 2025
· Search Engine Roundtable, Microsoft Confirms Schema Helps Its LLMs (Copilot) Understand Your Content
· Wikidata